PDF থেকে Excel
আপনার ডিভাইসেই চলে · আপনার ফাইল কখনও আপনার ডিভাইস ছেড়ে যায় না।
টেবিল আছে এমন PDF দিন — ব্যাংক স্টেটমেন্ট, দামের তালিকা, ইনভয়েস, রেজাল্ট শিট — আর পান .xlsx ওয়ার্কবুক, যেখানে প্রতি টেবিল আলাদা শিটে সত্যিকারের সেল হয়ে বসে, সাজানো আর যোগ করা যায়। সংখ্যা সংখ্যা হিসেবেই লেখা হয়, তাই ফর্মুলা সঙ্গে সঙ্গে কাজ করে।
টেবিল খুঁজে বের করা হয় শব্দগুলো লাইনে লাইনে যেভাবে কলাম হয়ে দাঁড়ায় তা দেখে — মানুষ যেভাবে পাতায় টেবিল দেখে। দাগ কাটা টেবিল না থাকলেও প্রতিটা লাইন কলামের ফাঁক ধরে ভেঙে সারি বানানো হয়, তাই স্টেটমেন্ট বা তালিকা একদলা লেখা না হয়ে গ্রিড হয়ে আসে।
সব কাজ আপনার ডিভাইসে। ব্যাংক স্টেটমেন্ট স্প্রেডশিট হতে গিয়ে অচেনা কারও সার্ভার ঘুরে আসবে — সেটা হওয়ার দরকার নেই।
হাতে-কলমে উদাহরণ: এই টুল চালিয়ে মাপা ফল
একজন ভিজিটর যেভাবে করতেন, সেভাবেই আমরা ব্রাউজারে এই পাতায় পণ্যের তালিকার টেবিলসহ এক পাতার একটি ইনভয়েস PDF (কাল্পনিক) (24.0 KB) চালিয়েছি, তারপর কী বেরোল তা যাচাই করেছি। নিচের সংখ্যাগুলো অনুমান নয় — ফলের ওপর মেপে পাওয়া।
- সেটিংস
- পাতার ডিফল্ট: একটি PDF, টেবিল থেকে শিট।
- নিজের সারিতে পাওয়া আইটেমের মান
- 18 / 18
- সংখ্যা হিসেবে সংরক্ষিত টাকার অঙ্ক
- 18 / 18
- শিটে লাইনগুলোর মোটের যোগফল = ইনভয়েসে ছাপা মোট
- 405.8 = 405.8 (6 / 6)
- টেস্ট ব্রাউজারে লাগা সময়, বোতাম থেকে ফল পর্যন্ত
- 0.5 s
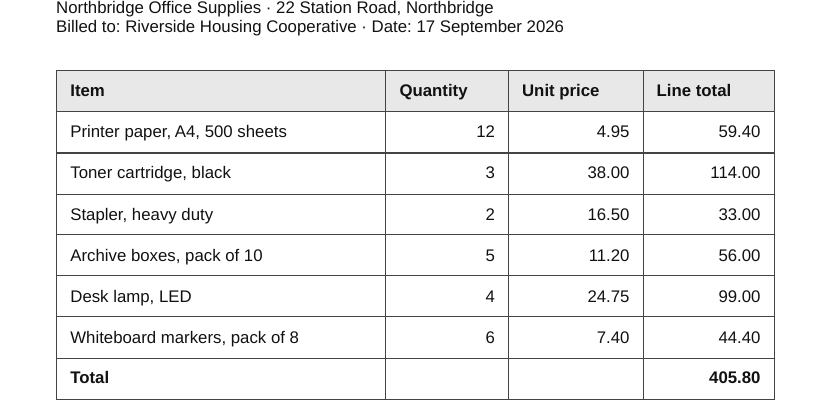
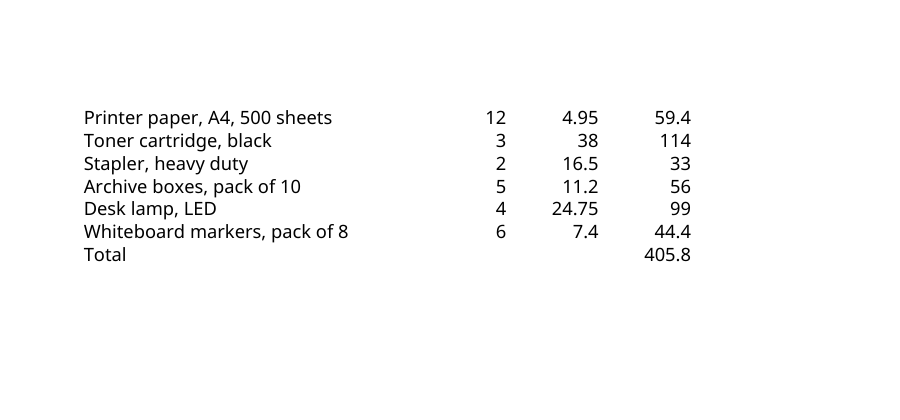
এই উদাহরণ যা দেখায় না: এই ইনভয়েসটা দাগটানা টেবিলসহ টেক্সট-ভিত্তিক PDF। স্ক্যান করা ইনভয়েসে টেক্সট লেয়ার থাকে না, তাই এভাবে পড়া যায় না; যেসব স্টেটমেন্টে কলামের দাগ নেই, সেগুলো এমন সারি হিসেবে আসে যেগুলো একটু গুছিয়ে নিতে হতে পারে।
2026-09-25 তারিখে সাইটের নিজের কোড দিয়ে মাপা (বিল্ড 8672737)। ফাইল: office-supplies-invoice.pdf ফল
PDF থেকে Excel: কীভাবে করবেন
- PDF দিন।
- «Excel-এ কনভার্ট করুন» চাপুন।
- .xlsx খুলুন — প্রতি টেবিলের জন্য এক শিট।
সমর্থিত ফরম্যাট ও সীমা
- ইনপুট
- লেখার স্তর আছে এমন PDF (স্টেটমেন্ট, ইনভয়েস, দামের তালিকা, রিপোর্ট)
- আউটপুট
- Excel ওয়ার্কবুক (.xlsx), প্রতি টেবিলে এক শিট, সংখ্যা সংখ্যাই
- যেখানে চলে
- আপনার ব্রাউজারেই; ফাইল কখনো আপলোড হয় না
যার জন্য নয়: স্ক্যান করা PDF — আগে OCR লাগে। ছবি হিসেবে আঁকা টেবিলও পড়া যায় না।
সাধারণ জিজ্ঞাসা
- স্ক্যান করা PDF চলবে?
- চলবে না। স্ক্যানে লেখার স্তর থাকে না; আগে PDF OCR চালাতে হয়; ছাপা বাংলা আর ইংরেজি দুটোই সেটা পড়তে পারে।
- আমার ফাইল কি কোনো সার্ভারে আপলোড হয়?
- না। পুরো কাজটা হয় আপনার ব্রাউজারেই, আপনার নিজের ফোন বা কম্পিউটারের ক্ষমতায়। ফাইল ডিভাইস ছেড়ে কোথাও যায় না। কোনো টুল একবার ব্যবহার করা হয়ে গেলে ইন্টারনেট ছাড়াও সেটা চলে — ভিডিও, লেখা চেনা আর ব্যাকগ্রাউন্ড সরানোর টুল প্রথমবার নিজের ইঞ্জিন এই সাইট থেকে নামিয়ে নেয়, তারপর ব্রাউজার সেটা রেখে দেয়।
- সংখ্যা কি টেক্সট হয়ে যাবে?
- না। সংখ্যাগুলো সংখ্যা হিসেবেই লেখা হয়, তাই SUM বা গড় সঙ্গে সঙ্গে চলে।
- একাধিক টেবিল থাকলে?
- প্রতিটা টেবিল আলাদা শিট হয়, তাই কোনটা কোথায় তা গুলিয়ে যায় না।
- বাংলা লেখা আসবে তো?
- PDF-টা Unicode বাংলায় বানানো হলে আসবে। পুরোনো বিজয়/ASCII ফন্টে বানানো PDF-এ অক্ষরগুলো ফাইলের ভেতরেই ওভাবে জমা থাকে, তাই সেখান থেকে ঠিক বাংলা বেরোয় না।
সম্পর্কিত টুল
এই পাতা অন্য ভাষায়: English · العربية · Deutsch · Français · Español · Русский · Português · 中文 · हिन्दी · Türkçe · עברית · فارسی · اردو · Bahasa Indonesia