Funciona en tu dispositivo · Tu archivo nunca sale de tu dispositivo.
Una carta fotografiada, una captura de pantalla, una factura escaneada: el reconocimiento de texto lee los caracteres de la imagen y te devuelve texto para copiar – o directamente un archivo Word o TXT.
El español se reconoce con sus acentos, eñes y signos de apertura; el inglés y el árabe también. El modelo se ejecuta en tu navegador – la imagen no se sube, así que tampoco una factura, un DNI o un informe médico.
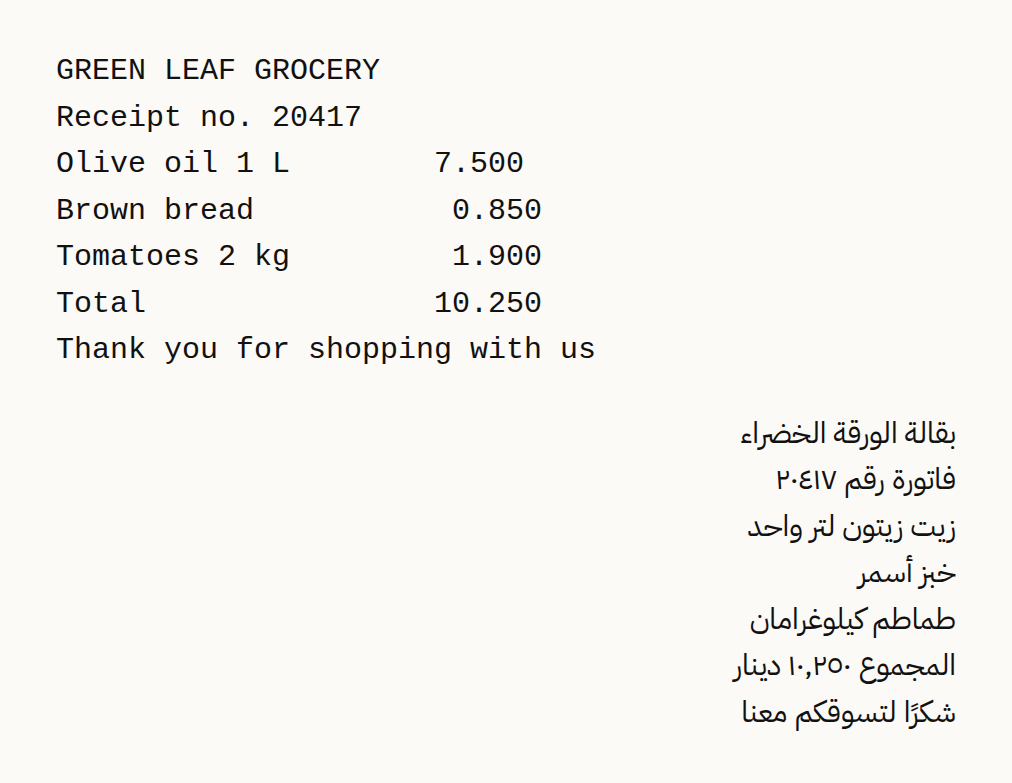
Pasamos una imagen de un ticket de compra en inglés y árabe (ficticio) (62.1 KB) por esta página en un navegador, tal como lo haría un visitante, y comprobamos lo que salió. Las cifras de abajo se midieron sobre el resultado; no son estimaciones.
Lo que este ejemplo no muestra: Es una imagen limpia y recta de texto impreso. Las fotos tomadas en ángulo, la letra manuscrita y la impresión tenue se leen peor. Revisa a ojo los nombres y las cifras antes de fiarte de ellos.
Medido el 2026-09-25 con el propio código del sitio (compilación 8672737). Archivos: grocery-receipt-ar-en.png resultado
No sirve para: Letra manuscrita y fuentes muy estilizadas – con texto impreso nítido el reconocimiento es fiable; en otros casos, menos.
La lista tiene 17 opciones: inglés, árabe, árabe e inglés juntos, alemán, francés, español, ruso, portugués, chino simplificado y tradicional, hindi, turco, hebreo, persa, urdu, indonesio y bengalí. Cada una carga el modelo de reconocimiento de ese idioma, así que elige el idioma en que está escrito el texto, no el de esta página. Un texto leído con el modelo equivocado sale con caracteres erróneos o sin sentido.
La opción también cambia cómo se dispone el texto. En los idiomas que se escriben de izquierda a derecha se conservan las secuencias de espacios, así que las columnas de un recibo o de una tabla sencilla siguen separadas. En los de derecha a izquierda esto está desactivado, porque en las pruebas juntaba palabras vecinas. Con el árabe seleccionado, los números escritos con cifras arábigo-índicas reciben una segunda lectura, porque el motor suele equivocarse con ellos en la primera.
Un archivo vacío, o uno que el navegador no puede abrir, se detiene con un mensaje que lo dice. Una foto HEIC de iPhone se convierte a JPG en tu dispositivo. El motor lee mal la letra pequeña, así que una imagen de menos de 1.600 píxeles de ancho se amplía a unos 1.800 píxeles antes de leerla, como mucho al cuádruple de su tamaño y sin pasar de 4.000 píxeles en el lado más largo.
Se pueden leer varias imágenes de una vez: en el texto, cada una empieza con una línea que nombra su archivo, y en el archivo Word cada una va bajo su propio título.
El porcentaje de confianza es la propia estimación del motor, promediada sobre todas las imágenes. No es una comparación con el texto real, así que vuelve a leer números, nombres e importes antes de fiarte de ellos.
El archivo TXT se guarda en UTF-8 con marca de orden de bytes (BOM), lo que ayuda al Bloc de notas de Windows a mostrar bien las letras no latinas. En el archivo Word cada línea se convierte en un párrafo. Con un idioma de derecha a izquierda (árabe, hebreo, persa o urdu), esos párrafos se escriben de derecha a izquierda y alineados a la derecha, y en un documento mixto la dirección se decide línea a línea, así que las líneas en inglés quedan alineadas a la izquierda.
Un archivo de 0 bytes suele ser una foto guardada en la nube que aún no se ha descargado al móvil: ábrela en tu galería y vuelve a elegirla. Una imagen abierta directamente desde una app de mensajería a veces no se puede leer; guárdala antes en el móvil o hazle una captura de pantalla.
Una foto torcida se lee peor que una recta. Enderézala con /rotate-image y recorta todo lo que no sea texto con /crop-image. Para un PDF escaneado, usa /pdf-ocr, que convierte cada página en imagen y las lee una a una.
Esta página en otros idiomas: English · العربية · Deutsch · Français · Русский · Português · 中文 · हिन्दी · Türkçe · עברית · فارسی · اردو · Bahasa Indonesia · বাংলা