Funciona no seu dispositivo · Seu arquivo nunca sai do seu dispositivo.
Uma carta fotografada, um print, uma nota fiscal escaneada: o reconhecimento de texto lê as letras da imagem e devolve texto para copiar — ou direto um arquivo Word ou TXT.
O português é reconhecido com acentos, cedilha e til; inglês e árabe também. O modelo roda no seu navegador — a imagem não é enviada, então nem boleto, nem RG, nem laudo médico saem do seu aparelho.
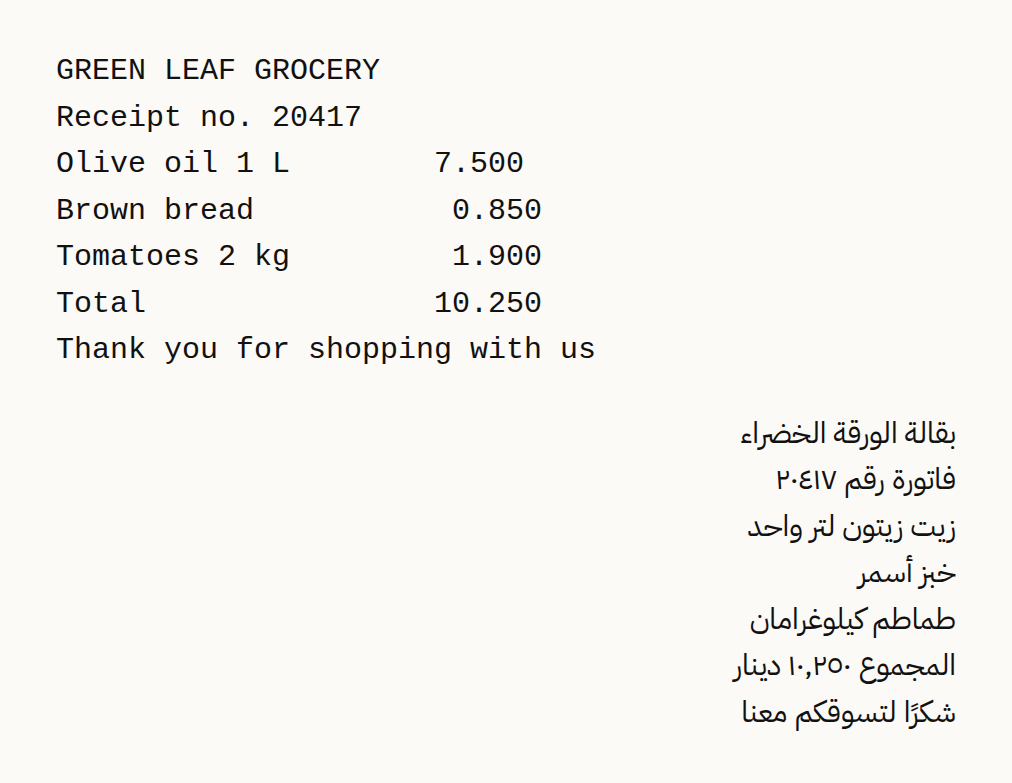
Passamos uma imagem de recibo de loja em inglês e árabe (fictício) (62.1 KB) por esta página em um navegador, do jeito que um visitante faria, e conferimos o que saiu. Os números abaixo foram medidos no resultado, não estimados.
O que este exemplo não mostra: Esta é uma imagem limpa e reta de texto impresso. Fotos tiradas em ângulo, letra à mão e impressão fraca são lidas com menos precisão. Confira nomes e números com os próprios olhos antes de confiar neles.
Medido em 2026-09-25 com o próprio código do site (build 8672737). Arquivos: grocery-receipt-ar-en.png resultado
Não serve para: Letra de mão e fontes muito estilizadas — em texto impresso nítido o reconhecimento é confiável; fora disso, menos.
A lista tem 17 opções: inglês, árabe, árabe e inglês juntos, alemão, francês, espanhol, russo, português, chinês simplificado e tradicional, hindi, turco, hebraico, persa, urdu, indonésio e bengali. Cada uma carrega o modelo de reconhecimento daquele idioma, então escolha o idioma em que o texto está escrito, não o idioma desta página. Texto lido com o modelo errado sai com caracteres errados ou sem sentido.
A opção também muda como o texto é organizado. Nos idiomas escritos da esquerda para a direita, as sequências de espaços são mantidas, então as colunas de um cupom fiscal ou de uma tabela simples continuam separadas. Nos idiomas da direita para a esquerda isso fica desligado, porque nos testes juntava palavras vizinhas. Com o árabe selecionado, números escritos com algarismos arábico-índicos recebem uma segunda leitura, porque o motor costuma errá-los na primeira.
Um arquivo vazio, ou que o navegador não consegue abrir, para com uma mensagem dizendo isso. Uma foto HEIC de iPhone é convertida em JPG no seu aparelho. O motor lê mal letras pequenas, então uma imagem com menos de 1.600 pixels de largura é ampliada para uns 1.800 pixels antes da leitura, no máximo quatro vezes o tamanho e sem passar de 4.000 pixels no lado maior.
Dá para ler várias imagens de uma vez: no texto, cada uma começa com uma linha com o nome do arquivo, e no arquivo Word cada uma fica sob um título próprio.
A porcentagem de confiança é a estimativa do próprio motor, na média de todas as imagens. Não é uma comparação com o texto real, então releia números, nomes e valores antes de confiar neles.
O arquivo TXT é salvo em UTF-8 com marca de ordem de bytes (BOM), o que ajuda o Bloco de Notas do Windows a mostrar corretamente letras não latinas. No arquivo Word, cada linha vira um parágrafo. Com um idioma da direita para a esquerda (árabe, hebraico, persa ou urdu), esses parágrafos ficam da direita para a esquerda e alinhados à direita, e num documento misto a direção é decidida linha por linha, então as linhas em inglês continuam alinhadas à esquerda.
Um arquivo de 0 bytes geralmente é uma foto guardada na nuvem que ainda não foi baixada para o celular: abra-a na galeria e escolha de novo. Uma imagem aberta direto de um app de mensagens às vezes não pode ser lida; salve-a antes no celular ou tire um print dela.
Uma foto torta é lida pior que uma reta. Endireite-a com /rotate-image e corte tudo o que não for texto com /crop-image. Para um PDF escaneado, use /pdf-ocr, que transforma cada página em imagem e lê uma por uma.
Esta página em outros idiomas: English · العربية · Deutsch · Français · Español · Русский · 中文 · हिन्दी · Türkçe · עברית · فارسی · اردو · Bahasa Indonesia · বাংলা