Cihazınızda çalışır · Dosyanız cihazınızdan asla çıkmaz.
Bir belgenin fotoğrafı, ekran görüntüsü ya da tarama: yazıyı buradan düzenlenebilir metne çevirin. Türkçe metin tanıma cihazınızda çalışır; ş, ğ, ı, ö, ü, ç doğru okunur.
Sonucu kopyalayın ya da TXT ve Word olarak indirin. Fotoğraf sunucuya gitmez; kimlik, fatura ya da sözleşme gibi özel belgeler için güvenlidir.
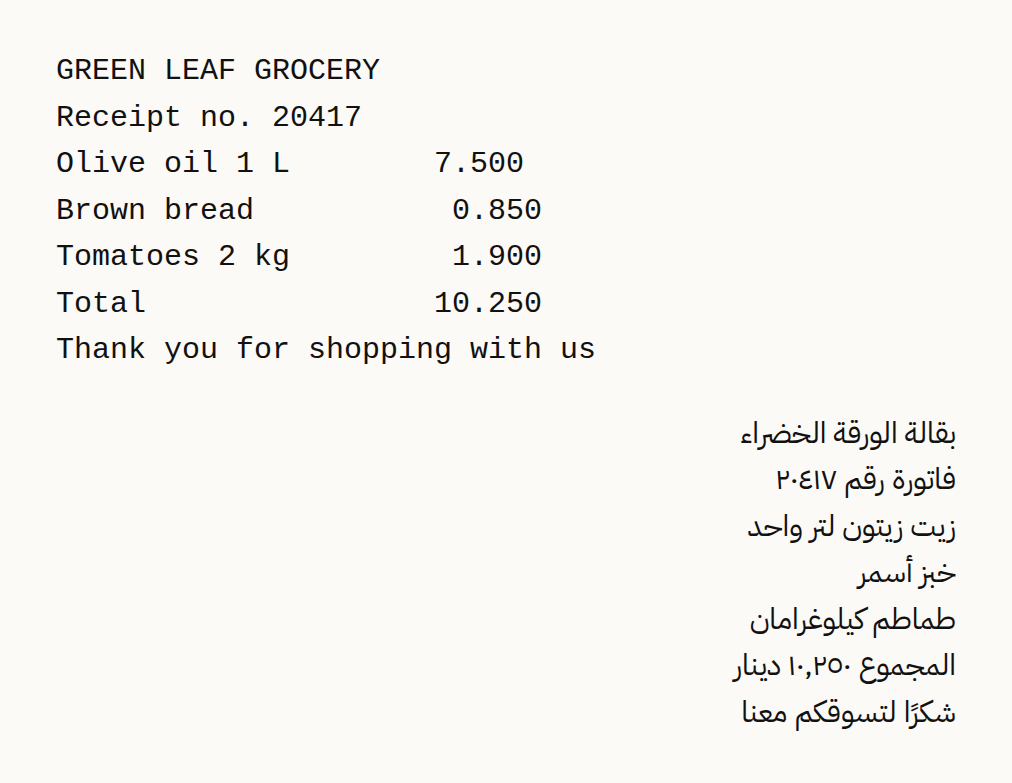
Bu sayfayı bir ziyaretçi gibi tarayıcıda kullandık: girdi olarak İngilizce ve Arapça bir alışveriş fişinin görüntüsü (kurgusal) (62.1 KB) verdik ve çıkan sonucu kontrol ettik. Aşağıdaki değerler tahmin değil, doğrudan sonuç üzerinde ölçüldü.
Bu örneğin göstermedikleri: Bu, basılı metnin temiz ve düz bir görüntüsü. Açılı çekilmiş fotoğraflar, el yazısı ve soluk baskı daha zayıf okunur. Adlara ve rakamlara güvenmeden önce onları gözle kontrol edin.
2026-09-25 tarihinde sitenin kendi koduyla ölçüldü (derleme 8672737). Dosyalar: grocery-receipt-ar-en.png sonuç
Şunlar için uygun değildir: Bulanık ya da çok küçük yazılı fotoğraflar; tanıma, gözün okuyabildiği kadarını okur.
Listede 17 ayar var: İngilizce, Arapça, Arapça ve İngilizce birlikte, Almanca, Fransızca, İspanyolca, Rusça, Portekizce, Basitleştirilmiş ve Geleneksel Çince, Hintçe, Türkçe, İbranice, Farsça, Urduca, Endonezce ve Bengalce. Her biri o dilin tanıma modelini yükler; bu yüzden bu sayfanın dilini değil, metnin yazıldığı dili seçin. Yanlış modelle okunan metin yanlış ya da anlamsız karakterler olarak çıkar.
Ayar, metnin nasıl dizileceğini de değiştirir. Soldan sağa yazılan dillerde art arda gelen boşluklar korunur; böylece bir fişin ya da basit bir tablonun sütunları ayrı kalır. Sağdan sola yazılan dillerde bu kapalıdır, çünkü denemelerde yan yana sözcükleri birleştirdi. Arapça seçildiğinde Arap-Hint rakamlarıyla yazılmış sayılar ikinci kez okunur, çünkü motor bunları ilk seferde sık sık yanlış okur.
Boş bir dosya ya da tarayıcının açamadığı bir dosya, bunu söyleyen bir mesajla durur. iPhone’un HEIC fotoğrafı cihazınızda JPG’ye çevrilir. Motor küçük yazıyı kötü okur; bu yüzden 1.600 pikselden dar bir görsel, okunmadan önce yaklaşık 1.800 piksel genişliğe büyütülür: en fazla dört katına ve uzun kenarda 4.000 pikseli geçmeyecek şekilde.
Birden çok görsel tek seferde okunabilir; metinde her biri dosya adını veren bir satırla başlar, Word dosyasında ise her biri kendi başlığının altında durur.
Güven yüzdesi motorun kendi tahminidir ve bütün görsellerin ortalamasıdır. Gerçek metinle yapılmış bir karşılaştırma değildir; sayılara, adlara ve tutarlara güvenmeden önce onları bir kez daha okuyun.
TXT dosyası bayt sırası işaretiyle (BOM) UTF-8 olarak kaydedilir; bu, Windows Not Defteri’nin Latin dışı harfleri doğru göstermesine yardımcı olur. Word dosyasında her satır ayrı bir paragraf olur. Sağdan sola bir ayarda (Arapça, İbranice, Farsça ya da Urduca) bu paragraflar sağdan sola dizilir ve sağa hizalanır; karışık bir belgede yön satır satır belirlenir, böylece İngilizce satırlar sola hizalı kalır.
0 baytlık bir dosya genellikle bulutta tutulan ve henüz telefona inmemiş bir fotoğraf demektir: önce galerinizde açın, sonra yeniden seçin. Doğrudan bir mesajlaşma uygulamasından açılan bir görsel bazen okunamaz; önce telefona kaydedin ya da ekran görüntüsünü alın.
Eğik bir fotoğrafı /rotate-image ile düzeltin, metin dışındaki her şeyi /crop-image ile kesip atın. Taranmış bir PDF için /pdf-ocr aracı her sayfayı görsele çevirip tek tek okur.
Metin ve belgeler içinde daha fazlası
Bu sayfa diğer dillerde: English · العربية · Deutsch · Français · Español · Русский · Português · 中文 · हिन्दी · עברית · فارسی · اردو · Bahasa Indonesia · বাংলা