在你的设备上运行 · 你的文件从不离开你的设备。
拍下来的通知、聊天截图、扫描的发票:文字识别会读出图片里的文字,直接复制,或者保存为Word、TXT文件。
识别简体中文、繁体中文、英文等语言——选择文字本身所用的那一种。识别模型在你的浏览器里运行——图片不上传,所以发票、身份证、病历都不会离开你的设备。
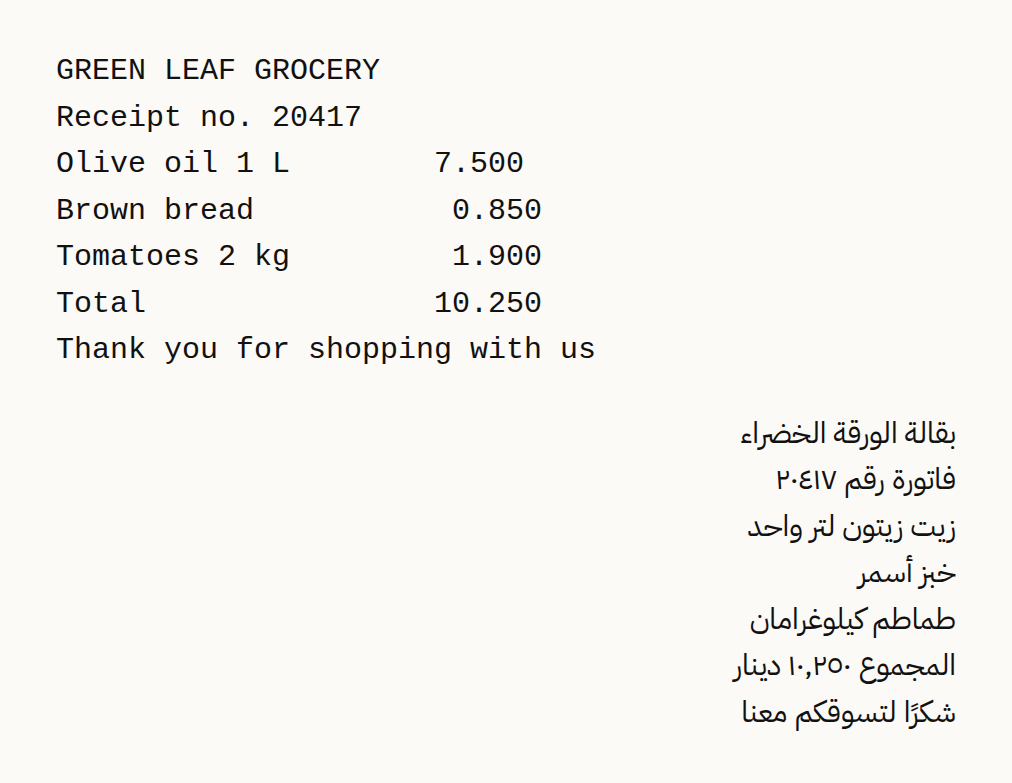
我们像普通访客一样,在浏览器中用本页面处理了一张英语、阿拉伯语双语的商店收据图片(虚构)(62.1 KB),并检查了输出结果。以下数据均在结果上实测得出,而非估算。
本示例未能说明的情况: 这是一张干净、端正的印刷文字图片。斜着拍的照片、手写字和印迹模糊的文字,识别效果会差一些。在依赖识别结果之前,请亲自核对姓名和数字。
于 2026-09-25 使用本站自身代码测量(构建版本 8672737)。文件: grocery-receipt-ar-en.png 结果
不适用于: 手写体和艺术字——清晰的印刷体识别可靠,其他情况效果较差。
列表里有17个设置:英语、阿拉伯语、阿拉伯语+英语、德语、法语、西班牙语、俄语、葡萄牙语、简体中文、繁体中文、印地语、土耳其语、希伯来语、波斯语、乌尔都语、印尼语和孟加拉语。每个设置加载对应语言的识别模型,所以要选文字本身所用的语言,而不是这个页面的语言。用错了模型,识别出来的会是错字或毫无意义的字符。
这个设置还会影响文字的排版。从左到右书写的语言会保留连续的空格,收据或简单表格的各列就不会挤在一起。从右到左的语言关闭了这一项,因为测试中它会把相邻的词连在一起。选择阿拉伯语时,用阿拉伯-印度数字写的数字会再识别一次,因为引擎第一遍常常认错。
空文件或浏览器打不开的文件会直接停下,并提示原因。iPhone的HEIC照片在你的设备上转为JPG。引擎读小字效果差,所以宽度不足1,600像素的图片会先放大到约1,800像素宽再识别,最多放大到原来的四倍,最长边不超过4,000像素。
可以一次识别多张图片:文本里每张图片的内容以一行文件名开头,Word文件里每张图片各在自己的标题下。
置信度百分比是引擎自己的估计,取所有图片的平均值。它不是和真实文字比对的结果,所以数字、姓名和金额在使用前请再核对一遍。
TXT文件以带字节顺序标记(BOM)的UTF-8保存,这能帮助Windows记事本正确显示非拉丁文字。Word文件里每一行是一个段落。选择从右到左的设置(阿拉伯语、希伯来语、波斯语或乌尔都语)时,这些段落设为从右到左并右对齐;混合文档逐行判断方向,所以英文行仍然左对齐。
0字节的文件通常是存在云端、还没下载到手机上的照片:先在相册里打开它,再重新选择。直接从聊天软件里打开的图片有时读不出来;先保存到手机,或者截个屏。
拍歪的照片比拍正的识别效果差。用/rotate-image把它转正,再用/crop-image只留下文字部分。扫描件PDF请用/pdf-ocr,它会把每一页变成图片,逐页识别。
本页的其他语言版本: English · العربية · Deutsch · Français · Español · Русский · Português · हिन्दी · Türkçe · עברית · فارسی · اردو · Bahasa Indonesia · বাংলা