روی دستگاه شما اجرا میشود · فایل شما از دستگاهتان خارج نمیشود.
عکس یک سند، اسکرینشات یا اسکن: نوشته را همینجا به متن قابل ویرایش تبدیل کنید. تشخیص متن فارسی روی دستگاه شما اجرا میشود، راستبهچپ.
نتیجه را کپی کنید یا بهصورت TXT و Word دانلود کنید. عکس به سرور نمیرود؛ برای کارت ملی، فاکتور یا قرارداد امن است.
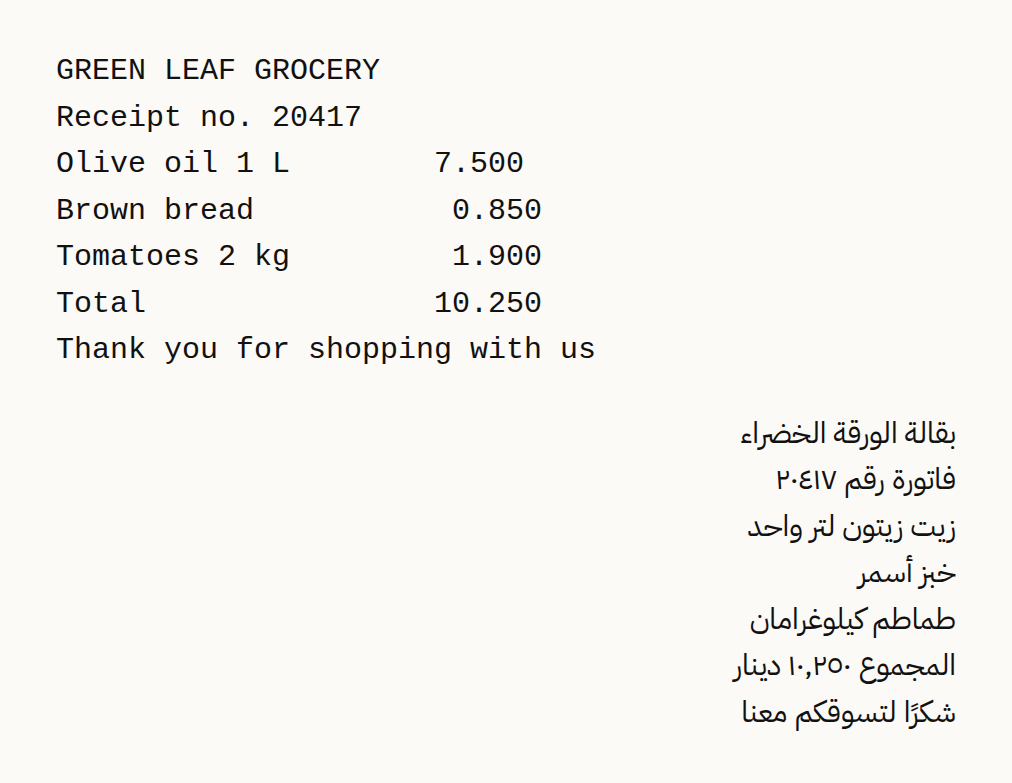
تصویر رسید یک فروشگاه به انگلیسی و عربی (ساختگی) (62.1 KB) را، همانطور که یک بازدیدکننده این کار را میکند، در مرورگر از این صفحه گذراندیم و خروجی را بررسی کردیم. اعداد زیر روی خود نتیجه اندازهگیری شدهاند، نه تخمین زده شدهاند.
آنچه این نمونه نشان نمیدهد: این تصویری تمیز و صاف از متن چاپی است. عکسهایی که با زاویه گرفته شدهاند، دستخط و چاپ کمرنگ کمتر درست خوانده میشوند. پیش از آنکه به نامها و عددها تکیه کنید، خودتان آنها را با چشم بررسی کنید.
اندازهگیریشده در 2026-09-25 با کد خود سایت (نسخهٔ 8672737). فایلها: grocery-receipt-ar-en.png نتیجه
مناسب نیست برای: عکسهای تار یا با نوشتهٔ خیلی ریز؛ تشخیص فقط آنچه را چشم میخواند میخواند.
فهرست ۱۷ گزینه دارد: انگلیسی، عربی، عربی و انگلیسی با هم، آلمانی، فرانسوی، اسپانیایی، روسی، پرتغالی، چینی سادهشده و چینی سنتی، هندی، ترکی، عبری، فارسی، اردو، اندونزیایی و بنگالی. هر گزینه مدل تشخیص همان زبان را بار میکند؛ پس زبانی را انتخاب کنید که متن به آن نوشته شده، نه زبان این صفحه. متنی که با مدل اشتباه خوانده شود به نویسههای غلط یا بیمعنی تبدیل میشود.
این تنظیم چیدمان متن را هم تغییر میدهد. در زبانهای چپبهراست، فاصلههای پشت سر هم نگه داشته میشوند تا ستونهای یک رسید یا جدول ساده از هم جدا بمانند. در زبانهای راستبهچپ این کار خاموش است، چون در آزمایشها کلمههای کنار هم را به هم میچسباند. وقتی عربی انتخاب شده باشد، عددهایی که با رقمهای عربی-هندی نوشته شدهاند یک بار دیگر خوانده میشوند، چون موتور در خواندن اول اغلب اشتباهشان میخواند.
فایل خالی، یا فایلی که مرورگر نمیتواند باز کند، با پیامی که همین را میگوید متوقف میشود. عکس HEIC آیفون روی دستگاه خودتان به JPG تبدیل میشود. موتور متن ریز را بد میخواند؛ پس عکسی که عرضش کمتر از ۱٬۶۰۰ پیکسل باشد پیش از خواندن تا حدود ۱٬۸۰۰ پیکسل عرض بزرگ میشود، حداکثر تا چهار برابر اندازهاش و نه بیشتر از ۴٬۰۰۰ پیکسل در بلندترین ضلع.
چند عکس را میتوان یکجا خواند؛ در متن، هر کدام با سطری شروع میشود که نام فایلش را میگوید و در فایل Word هر کدام زیر عنوان خودش میآید.
درصد اطمینان برآورد خود موتور است که روی همهٔ عکسها میانگین گرفته شده. مقایسه با متن واقعی نیست؛ پس عددها، نامها و مبلغها را پیش از اینکه به آنها تکیه کنید دوباره بخوانید.
فایل TXT با کدگذاری UTF-8 و نشانهٔ ترتیب بایت (BOM) ذخیره میشود که به Notepad ویندوز کمک میکند حروف غیرلاتین را درست نشان دهد. در فایل Word هر سطر پاراگرافی جداگانه میشود. با تنظیم راستبهچپ (عربی، عبری، فارسی یا اردو)، این پاراگرافها راستبهچپ و راستچین میشوند و در سند ترکیبی جهت هر سطر جداگانه تعیین میشود؛ پس سطرهای انگلیسی چپچین میمانند.
فایل ۰ بایتی معمولاً یعنی عکسی که در فضای ابری نگه داشته شده و هنوز روی گوشی دانلود نشده است: آن را در گالری باز کنید و دوباره انتخابش کنید. عکسی که مستقیم از یک پیامرسان باز شده گاهی خوانده نمیشود؛ اول آن را روی گوشی ذخیره کنید یا از آن اسکرینشات بگیرید.
عکس کج بدتر از عکس صاف خوانده میشود. آن را با /rotate-image صاف کنید و با /crop-image همهچیز جز متن را ببُرید. برای PDF اسکنشده از /pdf-ocr استفاده کنید که هر صفحه را به تصویر تبدیل میکند و تکتک میخواند.
این صفحه به زبانهای دیگر: English · العربية · Deutsch · Français · Español · Русский · Português · 中文 · हिन्दी · Türkçe · עברית · اردو · Bahasa Indonesia · বাংলা