आपके डिवाइस पर चलता है · आपकी फ़ाइल कभी आपके डिवाइस से बाहर नहीं जाती।
खींची हुई चिट्ठी, स्क्रीनशॉट, स्कैन किया बिल: टेक्स्ट पहचान तस्वीर में लिखे अक्षर पढ़कर आपको कॉपी करने लायक टेक्स्ट देती है — या सीधे Word या TXT फ़ाइल।
हिन्दी देवनागरी में पहचानी जाती है, अंग्रेज़ी भी। मॉडल आपके ब्राउज़र में चलता है — तस्वीर अपलोड नहीं होती, इसलिए न बिल, न आधार, न कोई मेडिकल रिपोर्ट आपके डिवाइस से बाहर जाती है।
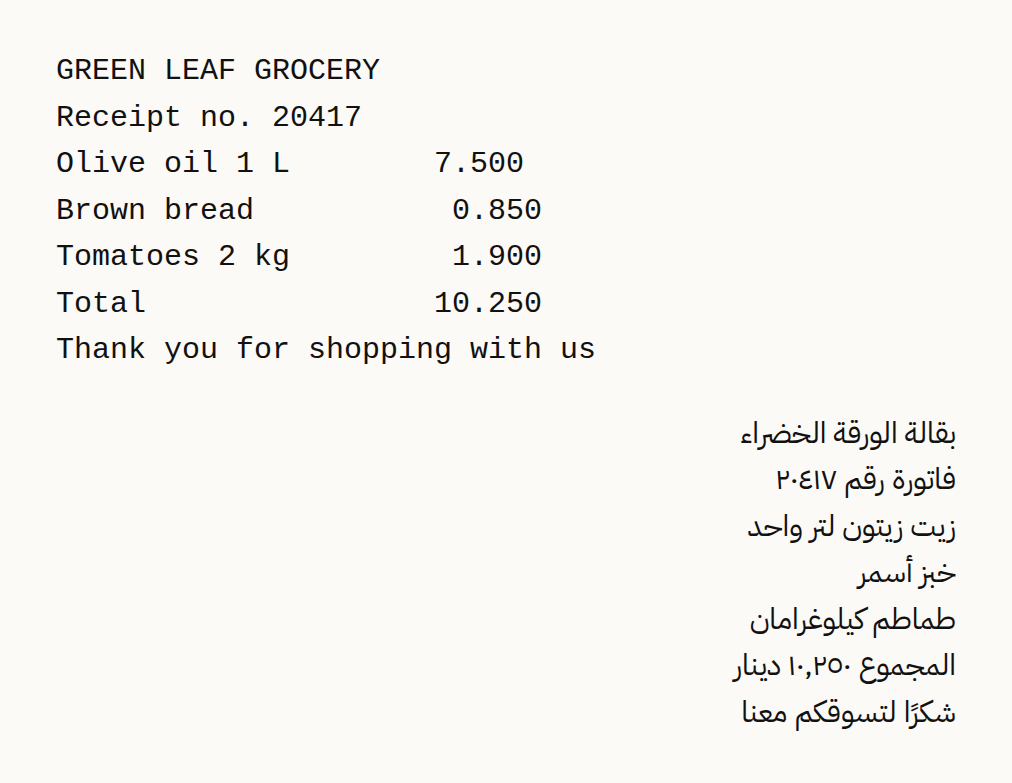
हमने अंग्रेज़ी और अरबी में दुकान की रसीद की तस्वीर (काल्पनिक) (62.1 KB) को इसी पेज पर ब्राउज़र में वैसे ही चलाया जैसे कोई विज़िटर चलाता, और देखा कि क्या निकला। नीचे के आँकड़े अनुमान नहीं हैं — ये नतीजे पर नापे गए हैं।
यह उदाहरण क्या नहीं दिखाता: यह छपे हुए टेक्स्ट की साफ़, सीधी तस्वीर है। तिरछे कोण से ली गई फ़ोटो, हाथ की लिखावट और फीकी छपाई कम अच्छी तरह पढ़ी जाती है। नामों और अंकों पर भरोसा करने से पहले उन्हें अपनी आँखों से जाँच लें।
2026-09-25 को साइट के अपने कोड से नापा गया (बिल्ड 8672737)। फ़ाइलें: grocery-receipt-ar-en.png नतीजा
इनके लिए नहीं: हाथ की लिखावट और बहुत सजावटी फ़ॉन्ट — साफ़ छपे टेक्स्ट पर पहचान भरोसेमंद है, बाक़ी में कम।
सूची में 17 सेटिंग हैं: अंग्रेज़ी, अरबी, अरबी और अंग्रेज़ी एक साथ, जर्मन, फ़्रेंच, स्पेनिश, रूसी, पुर्तगाली, सरलीकृत और पारंपरिक चीनी, हिन्दी, तुर्की, हिब्रू, फ़ारसी, उर्दू, इंडोनेशियाई और बांग्ला। हर सेटिंग उस भाषा का पहचान मॉडल लोड करती है, इसलिए वह भाषा चुनिए जिसमें टेक्स्ट लिखा है, न कि इस पेज की भाषा। ग़लत मॉडल से पढ़ा गया टेक्स्ट ग़लत या बेमतलब अक्षरों में निकलता है।
यह सेटिंग टेक्स्ट की बनावट भी बदलती है। बाएँ से दाएँ लिखी जाने वाली भाषाओं में लगातार कई खाली जगहें बनी रहती हैं, ताकि रसीद या साधारण टेबल के कॉलम अलग-अलग रहें। दाएँ से बाएँ लिखी जाने वाली भाषाओं में यह बंद है, क्योंकि परीक्षणों में इससे पास-पास के शब्द आपस में जुड़ गए थे। अरबी चुनने पर अरबी-भारतीय अंकों में लिखी संख्याएँ दूसरी बार पढ़ी जाती हैं, क्योंकि इंजन पहली बार में उन्हें अक्सर ग़लत पढ़ता है।
ख़ाली फ़ाइल, या ऐसी फ़ाइल जिसे ब्राउज़र खोल न सके, वहीं रुक जाती है और संदेश यह बता देता है। iPhone की HEIC फ़ोटो आपके डिवाइस पर ही JPG में बदली जाती है। इंजन छोटे अक्षर ठीक से नहीं पढ़ता, इसलिए 1,600 पिक्सेल से कम चौड़ी तस्वीर पढ़ने से पहले लगभग 1,800 पिक्सेल चौड़ी की जाती है — अपने आकार के ज़्यादा से ज़्यादा चार गुना तक, और लंबी भुजा पर 4,000 पिक्सेल से ज़्यादा नहीं।
कई तस्वीरें एक बार में पढ़ी जा सकती हैं; टेक्स्ट में हर तस्वीर उसकी फ़ाइल के नाम वाली पंक्ति से शुरू होती है, और Word फ़ाइल में हर एक अपनी हेडिंग के नीचे होती है।
विश्वसनीयता का प्रतिशत इंजन का अपना अनुमान है, सारी तस्वीरों का औसत। यह असली टेक्स्ट से की गई तुलना नहीं है, इसलिए संख्याएँ, नाम और रक़में इस्तेमाल करने से पहले दोबारा पढ़ लीजिए।
TXT फ़ाइल UTF-8 में, बाइट-ऑर्डर मार्क (BOM) के साथ सेव होती है, जिससे Windows Notepad में ग़ैर-लैटिन अक्षर सही दिखते हैं। Word फ़ाइल में हर पंक्ति अपना अलग पैराग्राफ़ बनती है। दाएँ से बाएँ वाली सेटिंग (अरबी, हिब्रू, फ़ारसी या उर्दू) में ये पैराग्राफ़ दाएँ से बाएँ और दाईं ओर संरेखित रखे जाते हैं, और मिले-जुले डॉक्यूमेंट में दिशा हर पंक्ति के लिए अलग तय होती है, इसलिए अंग्रेज़ी पंक्तियाँ बाईं ओर ही रहती हैं।
0 बाइट की फ़ाइल का मतलब अक्सर यह होता है कि फ़ोटो क्लाउड स्टोरेज में है और अभी फ़ोन पर डाउनलोड नहीं हुई: उसे गैलरी में खोलिए, फिर दोबारा चुनिए। मैसेजिंग ऐप से सीधे खोली गई तस्वीर कभी-कभी पढ़ी नहीं जा पाती; पहले उसे फ़ोन में सेव कीजिए, या उसका स्क्रीनशॉट ले लीजिए।
तिरछी फ़ोटो को /rotate-image से सीधा कीजिए और /crop-image से टेक्स्ट के अलावा सब काट दीजिए। स्कैन किए PDF के लिए /pdf-ocr इस्तेमाल कीजिए, जो हर पेज को तस्वीर बनाकर पढ़ता है।
यह पेज अन्य भाषाओं में: English · العربية · Deutsch · Français · Español · Русский · Português · 中文 · Türkçe · עברית · فارسی · اردو · Bahasa Indonesia · বাংলা