آپ کے آلے پر چلتا ہے · آپ کی فائل آپ کے آلے سے باہر نہیں جاتی۔
کسی دستاویز کی تصویر، اسکرین شاٹ یا اسکین: تحریر کو یہیں قابلِ ترمیم متن بنائیں۔ اردو متن شناخت آپ کے آلے پر چلتی ہے، دائیں سے بائیں۔
نتیجہ کاپی کریں یا TXT اور Word میں ڈاؤن لوڈ کریں۔ تصویر سرور پر نہیں جاتی؛ شناختی کارڈ، انوائس یا معاہدے کے لیے محفوظ ہے۔
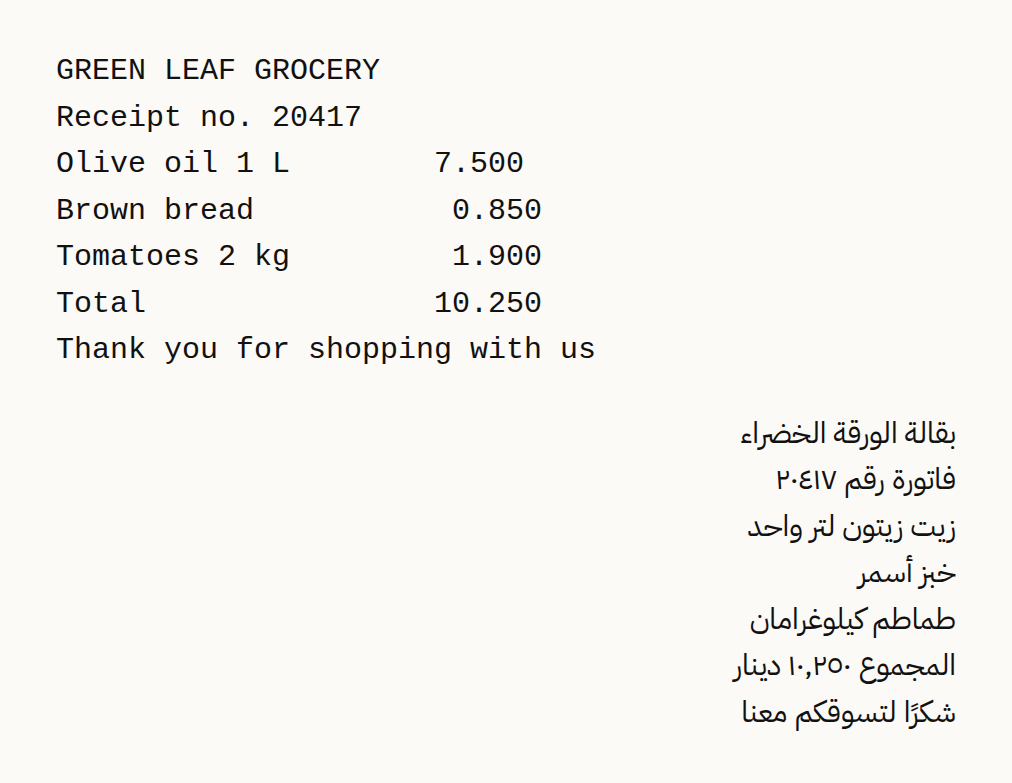
ہم نے انگریزی اور عربی میں دکان کی رسید کی ایک تصویر (فرضی) (62.1 KB) کو اس صفحے سے براؤزر میں گزارا، بالکل ویسے جیسے کوئی وزیٹر کرتا، اور جو نکلا اسے جانچا۔ نیچے دیے گئے اعداد نتیجے پر ناپے گئے ہیں، اندازے نہیں ہیں۔
یہ مثال کیا نہیں دکھاتی: یہ چھپے ہوئے متن کی صاف اور سیدھی تصویر ہے۔ ترچھے زاویے سے لی گئی تصاویر، ہاتھ کی لکھائی اور مدھم چھپائی کم اچھی طرح پڑھی جاتی ہیں۔ ناموں اور نمبروں پر بھروسا کرنے سے پہلے انہیں خود دیکھ کر جانچ لیں۔
2026-09-25 کو سائٹ کے اپنے کوڈ سے ناپا گیا (بلڈ 8672737)۔ فائلیں: grocery-receipt-ar-en.png نتیجہ
ان کے لیے نہیں: دھندلی یا بہت باریک تحریر والی تصویریں؛ شناخت اتنا ہی پڑھتی ہے جتنا آنکھ پڑھ سکے۔
فہرست میں 17 سیٹنگز ہیں: انگریزی، عربی، عربی اور انگریزی ایک ساتھ، جرمن، فرانسیسی، ہسپانوی، روسی، پرتگالی، سادہ اور روایتی چینی، ہندی، ترکی، عبرانی، فارسی، اردو، انڈونیشیائی اور بنگلہ۔ ہر سیٹنگ اسی زبان کا شناختی ماڈل لوڈ کرتی ہے، اس لیے وہ زبان چنیں جس میں تحریر لکھی ہے، اس صفحے کی زبان نہیں۔ غلط ماڈل سے پڑھا گیا متن غلط یا بے معنی حروف کی صورت میں نکلتا ہے۔
یہ سیٹنگ متن کی ترتیب بھی بدلتی ہے۔ بائیں سے دائیں لکھی جانے والی زبانوں میں لگاتار خالی جگہیں برقرار رکھی جاتی ہیں، تاکہ رسید یا سادہ جدول کے کالم الگ رہیں۔ دائیں سے بائیں زبانوں میں یہ بند ہے، کیونکہ آزمائش میں اس سے ساتھ والے الفاظ آپس میں جڑ گئے تھے۔ عربی چنی ہو تو عربی-ہندی ہندسوں میں لکھے اعداد دوسری بار پڑھے جاتے ہیں، کیونکہ انجن پہلی بار میں اکثر انہیں غلط پڑھتا ہے۔
خالی فائل، یا ایسی فائل جسے براؤزر کھول نہ سکے، ایک پیغام کے ساتھ رک جاتی ہے جو یہی بتاتا ہے۔ iPhone کی HEIC تصویر آپ کے آلے ہی پر JPG میں بدلتی ہے۔ انجن چھوٹی تحریر کمزور پڑھتا ہے، اس لیے 1,600 پکسل سے کم چوڑی تصویر پڑھنے سے پہلے تقریباً 1,800 پکسل چوڑی کی جاتی ہے، زیادہ سے زیادہ اپنے سائز کی چار گنا، اور لمبی طرف 4,000 پکسل سے زیادہ نہیں۔
کئی تصویریں ایک ساتھ پڑھی جا سکتی ہیں؛ متن میں ہر تصویر کا حصہ اس سطر سے شروع ہوتا ہے جس میں اس کی فائل کا نام ہو، اور Word فائل میں ہر ایک اپنی سرخی کے نیچے ہوتا ہے۔
اعتماد کا فیصد انجن کا اپنا اندازہ ہے، تمام تصویروں کا اوسط۔ یہ اصل متن سے موازنہ نہیں، اس لیے اعداد، نام اور رقمیں بھروسہ کرنے سے پہلے دوبارہ پڑھ لیں۔
TXT فائل UTF-8 میں بائٹ آرڈر مارک (BOM) کے ساتھ محفوظ ہوتی ہے، جس سے Windows کا Notepad غیر لاطینی حروف درست دکھاتا ہے۔ Word فائل میں ہر سطر اپنا الگ پیراگراف بنتی ہے۔ دائیں سے بائیں سیٹنگ (عربی، عبرانی، فارسی یا اردو) کے ساتھ یہ پیراگراف دائیں سے بائیں اور دائیں طرف سے جڑے (right-aligned) ہوتے ہیں، اور ملی جلی دستاویز میں سمت ہر سطر کے لیے الگ طے ہوتی ہے، اس لیے انگریزی سطریں بائیں طرف رہتی ہیں۔
0 بائٹ کی فائل کا مطلب عموماً یہ ہوتا ہے کہ تصویر کلاؤڈ اسٹوریج میں رکھی ہے اور ابھی فون پر ڈاؤن لوڈ نہیں ہوئی: اسے گیلری میں کھولیں، پھر دوبارہ چنیں۔ میسجنگ ایپ سے سیدھی کھولی گئی تصویر کبھی کبھی پڑھی نہیں جاتی؛ پہلے اسے فون میں محفوظ کریں، یا اس کا اسکرین شاٹ لے لیں۔
ٹیڑھی تصویر سیدھی تصویر سے کم اچھی پڑھی جاتی ہے۔ اسے /rotate-image سے سیدھا کریں اور /crop-image سے تحریر کے سوا سب کچھ کاٹ دیں۔ اسکین شدہ PDF کے لیے /pdf-ocr استعمال کریں، جو ہر صفحے کو تصویر بنا کر ایک ایک کر کے پڑھتا ہے۔
یہ صفحہ دوسری زبانوں میں: English · العربية · Deutsch · Français · Español · Русский · Português · 中文 · हिन्दी · Türkçe · עברית · فارسی · Bahasa Indonesia · বাংলা