Работает на вашем устройстве · Ваш файл никогда не покидает устройство.
Сфотографированное письмо, скриншот, отсканированный счёт: распознавание текста читает буквы с картинки и отдаёт вам текст для копирования — или сразу файл Word или TXT.
Русский распознаётся полностью, включая ё и знаки препинания; английский и арабский тоже. Модель работает в вашем браузере — картинка не загружается на сервер, а значит, ни счёт, ни паспорт, ни медицинская справка.
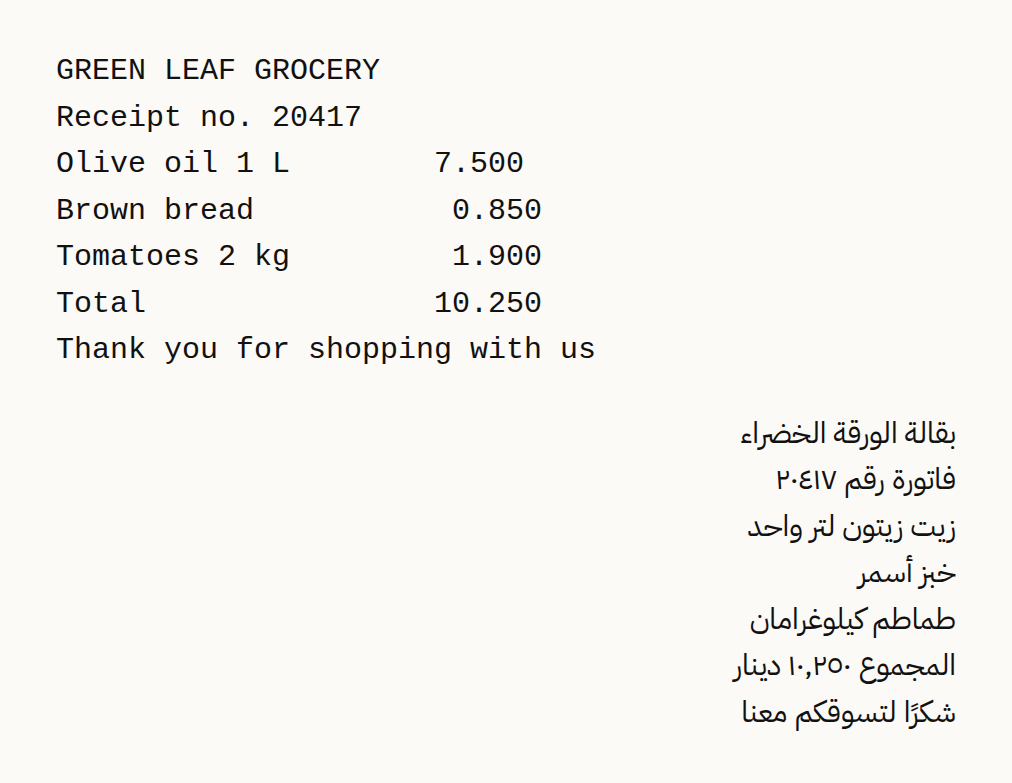
Файл для примера — изображение магазинного чека на английском и арабском (вымышленное) (62.1 KB). Мы обработали его на этой странице в браузере, как это сделал бы посетитель, и проверили, что получилось. Цифры ниже измерены на результате, а не прикинуты.
Чего этот пример не показывает: Это чистое, ровное изображение печатного текста. Фото, снятые под углом, рукописный текст и бледная печать распознаются хуже. Имена и цифры проверьте глазами, прежде чем на них полагаться.
Измерено 2026-09-25 собственным кодом сайта (сборка 8672737). Файлы: grocery-receipt-ar-en.png результат
Не подходит для: Рукописного текста и сильно стилизованных шрифтов — на чётком печатном тексте распознавание надёжно, в остальных случаях хуже.
В списке 17 вариантов: английский, арабский, арабский вместе с английским, немецкий, французский, испанский, русский, португальский, китайский упрощённый и традиционный, хинди, турецкий, иврит, персидский, урду, индонезийский и бенгальский. Каждый загружает модель распознавания своего языка, поэтому выбирайте язык, на котором написан текст, а не язык этой страницы. Текст, прочитанный не той моделью, превращается в неверные или бессмысленные символы.
От выбора зависит и то, как будет разложен текст. Для языков с письмом слева направо серии пробелов сохраняются, чтобы столбцы чека или простой таблицы не слипались. Для языков с письмом справа налево это отключено: в испытаниях соседние слова склеивались. Если выбран арабский, числа, записанные арабско-индийскими цифрами, читаются повторно, потому что с первого раза движок часто их путает.
Пустой файл или файл, который браузер не может открыть, останавливает работу с сообщением об этом. Фото HEIC с iPhone преобразуется в JPG на вашем устройстве. Мелкий текст движок читает плохо, поэтому картинка уже 1600 пикселей перед распознаванием увеличивается примерно до 1800 пикселей в ширину — но не более чем в четыре раза и не больше 4000 пикселей по длинной стороне.
Можно распознать сразу несколько картинок: в тексте каждая начинается со строки с именем её файла, а в файле Word каждая стоит под своим заголовком.
Процент уверенности — собственная оценка движка, усреднённая по всем картинкам. Это не сравнение с настоящим текстом, поэтому числа, имена и суммы перечитайте, прежде чем на них полагаться.
Файл TXT сохраняется в UTF-8 с меткой порядка байтов (BOM) — так «Блокнот» в Windows правильно показывает нелатинские буквы. В файле Word каждая строка становится отдельным абзацем. При языке с письмом справа налево (арабский, иврит, персидский или урду) абзацы получают направление справа налево и выравнивание по правому краю, а в смешанном документе направление определяется для каждой строки отдельно, так что английские строки остаются выровненными по левому краю.
Файл размером 0 байт обычно означает фото, которое хранится в облаке и ещё не скачалось на телефон: откройте его в галерее, а потом выберите снова. Картинку, открытую прямо из мессенджера, иногда не удаётся прочитать — сначала сохраните её на телефон или сделайте скриншот.
Наклонённый снимок выровняйте инструментом /rotate-image, а всё, кроме текста, обрежьте через /crop-image. Для отсканированного PDF есть /pdf-ocr: он превращает каждую страницу в картинку и распознаёт их по очереди.
Ещё в разделе Текст и документы
Эта страница на других языках: English · العربية · Deutsch · Français · Español · Português · 中文 · हिन्दी · Türkçe · עברית · فارسی · اردو · Bahasa Indonesia · বাংলা