פועל על המכשיר שלכם · הקובץ לא עוזב את המכשיר.
צילום של מסמך, צילום מסך או סריקה: הפכו את הכתב לטקסט שאפשר לערוך. זיהוי הטקסט בעברית רץ במכשיר שלכם, מימין לשמאל.
העתיקו את התוצאה או הורידו כ-TXT וכוורד. התמונה לא נשלחת לשרת; בטוח לתעודת זהות, לחשבוניות ולחוזים.
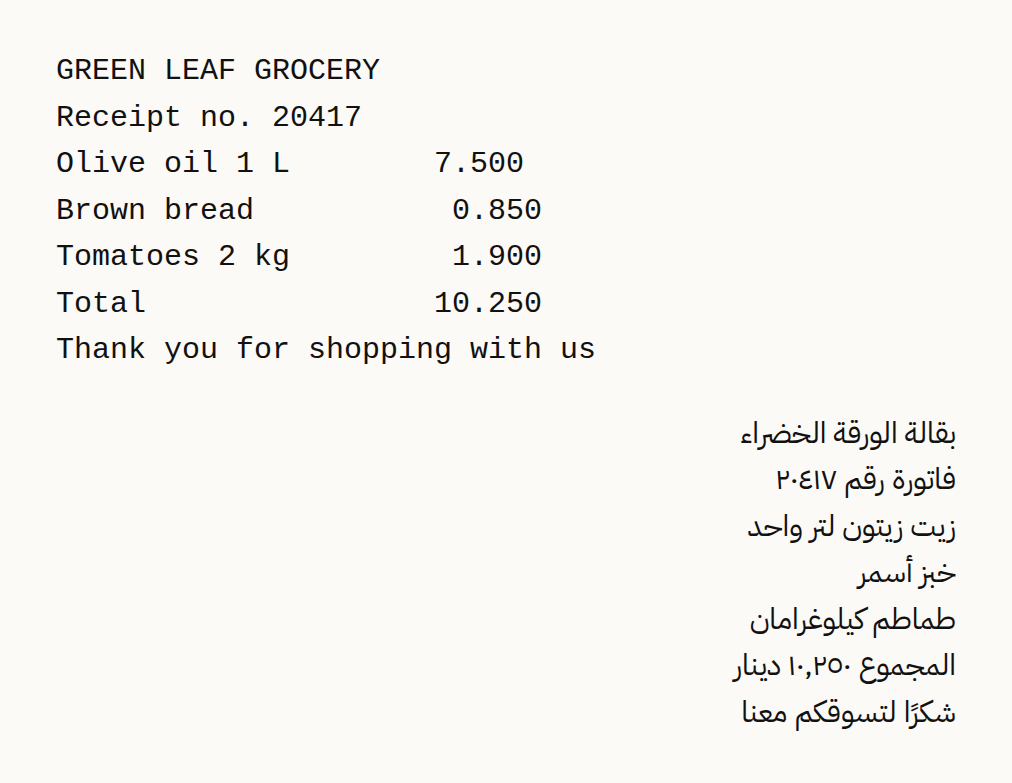
העברנו תמונה של קבלה מחנות, באנגלית ובערבית (בדויה) (62.1 KB) דרך העמוד הזה בדפדפן, כמו שמבקר היה עושה, ובדקנו מה יצא. הנתונים שלמטה נמדדו על התוצאה עצמה, הם לא הערכה.
מה הדוגמה הזו לא מראה: זו תמונה נקייה וישרה של טקסט מודפס. צילומים בזווית, כתב יד והדפסה דהויה מזוהים פחות טוב. בדקו בעיניים שמות ומספרים לפני שאתם מסתמכים עליהם.
נמדד ב-2026-09-25 בקוד של האתר עצמו (גרסה 8672737). קבצים: grocery-receipt-ar-en.png תוצאה
לא מיועד ל: תמונות מטושטשות או עם כתב קטן מדי; הזיהוי קורא רק מה שהעין קוראת.
ברשימה 17 הגדרות: אנגלית, ערבית, ערבית ואנגלית יחד, גרמנית, צרפתית, ספרדית, רוסית, פורטוגזית, סינית מפושטת, סינית מסורתית, הינדי, טורקית, עברית, פרסית, אורדו, אינדונזית ובנגלית. כל אחת טוענת את מודל הזיהוי של אותה שפה, אז בחרו את השפה שבה הטקסט כתוב, לא את שפת הדף הזה. טקסט שנקרא במודל הלא נכון יוצא כתווים שגויים או חסרי משמעות.
ההגדרה משנה גם את פריסת הטקסט. בשפות שנכתבות משמאל לימין נשמרים רצפי רווחים, כך שהעמודות של קבלה או של טבלה פשוטה נשארות נפרדות. בשפות מימין לשמאל זה כבוי, כי בבדיקות זה הדביק מילים סמוכות זו לזו. כשנבחרת ערבית, מספרים שכתובים בספרות ערביות-הודיות (١٢٣) נקראים פעם שנייה, כי המנוע טועה בהם לעתים קרובות בקריאה הראשונה.
קובץ ריק, או כזה שהדפדפן לא מצליח לפתוח, נעצר עם הודעה שאומרת זאת. תמונת HEIC מאייפון מומרת ל-JPG במכשיר שלכם. המנוע קורא טקסט קטן גרוע, ולכן תמונה צרה מ-1,600 פיקסלים מוגדלת לרוחב של כ-1,800 פיקסלים לפני הקריאה, עד פי ארבעה מגודלה ולא יותר מ-4,000 פיקסלים בצלע הארוכה.
אפשר לקרוא כמה תמונות בבת אחת; בטקסט, כל אחת מתחילה בשורה שמציינת את שם הקובץ שלה, ובקובץ הוורד כל אחת יושבת תחת כותרת משלה.
אחוז הביטחון הוא הערכה של המנוע עצמו, ממוצעת על פני כל התמונות. הוא לא השוואה לטקסט האמיתי, אז קראו שוב מספרים, שמות וסכומים לפני שאתם סומכים עליהם.
קובץ ה-TXT נשמר כ-UTF-8 עם סימן סדר בתים (BOM), שעוזר ל-Notepad של Windows להציג נכון אותיות שאינן לטיניות. בקובץ הוורד כל שורה הופכת לפסקה משלה. עם הגדרה מימין לשמאל (ערבית, עברית, פרסית או אורדו), הפסקאות האלה מוגדרות מימין לשמאל ומיושרות לימין, ובמסמך מעורב הכיוון נקבע שורה אחר שורה, כך ששורות באנגלית נשארות מיושרות לשמאל.
קובץ של 0 בייט פירושו בדרך כלל תמונה ששמורה באחסון ענן ועוד לא ירדה לטלפון: פתחו אותה בגלריה, ואז בחרו אותה שוב. תמונה שנפתחה ישירות מאפליקציית הודעות לפעמים לא ניתנת לקריאה; שמרו אותה קודם בטלפון, או צלמו אותה בצילום מסך.
תמונה עקומה נקראת גרוע יותר מתמונה ישרה. ישרו אותה עם /rotate-image וחתכו את כל מה שמסביב לטקסט עם /crop-image. ל-PDF סרוק השתמשו ב-/pdf-ocr, שהופך כל עמוד לתמונה וקורא כל אחת מהן.
עמוד זה בשפות אחרות: English · العربية · Deutsch · Français · Español · Русский · Português · 中文 · हिन्दी · Türkçe · فارسی · اردو · Bahasa Indonesia · বাংলা