Berjalan di perangkat Anda · File Anda tidak pernah meninggalkan perangkat.
Foto dokumen, tangkapan layar, atau hasil scan: ubah tulisannya menjadi teks yang bisa diedit. Pengenalan teks berjalan di perangkat Anda, dengan Bahasa Indonesia sudah terpilih.
Salin hasilnya atau unduh sebagai TXT dan Word. Foto tidak dikirim ke server; aman untuk KTP, invoice, atau kontrak.
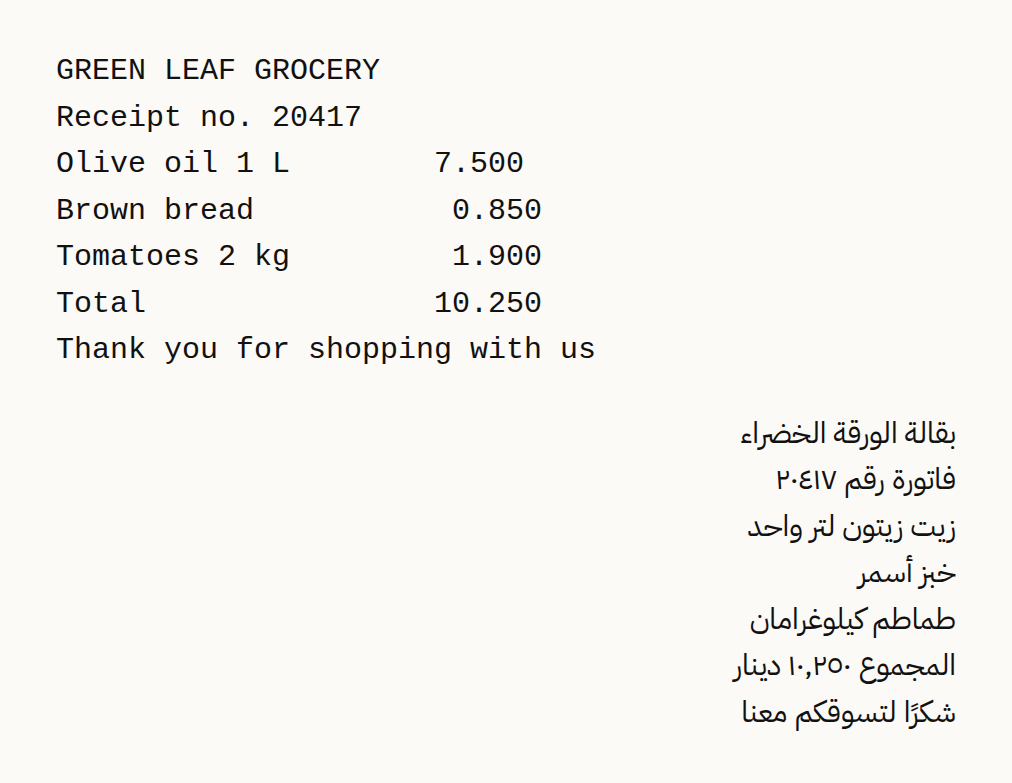
Kami menjalankan gambar struk belanja dalam bahasa Inggris dan Arab (fiktif) (62.1 KB) lewat halaman ini di peramban, persis seperti yang dilakukan pengunjung, lalu memeriksa hasilnya. Angka-angka di bawah diukur langsung pada hasilnya, bukan perkiraan.
Yang tidak ditunjukkan contoh ini: Ini adalah gambar teks cetak yang bersih dan lurus. Foto yang diambil dari sudut miring, tulisan tangan, dan cetakan pudar terbaca kurang baik. Periksa nama dan angka dengan mata sendiri sebelum Anda mengandalkannya.
Diukur pada 2026-09-25 dengan kode situs ini sendiri (build 8672737). Berkas: grocery-receipt-ar-en.png hasil
Tidak cocok untuk: Foto yang buram atau tulisannya terlalu kecil; pengenalan hanya membaca yang bisa dibaca mata.
Daftarnya berisi 17 pilihan: Inggris, Arab, Arab dan Inggris sekaligus, Jerman, Prancis, Spanyol, Rusia, Portugis, Mandarin Sederhana dan Tradisional, Hindi, Turki, Ibrani, Persia, Urdu, Indonesia, dan Bengali. Masing-masing memuat model pengenalan untuk bahasa itu, jadi pilih bahasa tulisan di gambar, bukan bahasa halaman ini. Teks yang dibaca dengan model yang salah keluar sebagai huruf yang keliru atau tak bermakna.
Pengaturan ini juga mengubah susunan teks. Untuk bahasa yang ditulis dari kiri ke kanan, deretan spasi dipertahankan, sehingga kolom-kolom struk atau tabel sederhana tetap terpisah. Untuk bahasa yang ditulis dari kanan ke kiri, fitur ini dimatikan, karena dalam pengujian justru menyambung kata-kata yang berdekatan. Kalau Arab dipilih, angka yang ditulis dengan digit Arab-India dibaca sekali lagi, karena mesin sering salah membacanya pada percobaan pertama.
File kosong, atau file yang tidak bisa dibuka browser, berhenti dengan pesan yang menjelaskannya. Foto HEIC dari iPhone diubah ke JPG di perangkat Anda. Mesin kurang baik membaca teks kecil, jadi gambar yang lebarnya kurang dari 1.600 piksel diperbesar ke sekitar 1.800 piksel sebelum dibaca, paling banyak empat kali ukurannya dan tidak lebih dari 4.000 piksel di sisi terpanjang.
Beberapa gambar bisa dibaca sekaligus; di teks, setiap gambar diawali satu baris berisi nama filenya, dan di file Word setiap gambar berada di bawah judulnya sendiri.
Persentase keyakinan adalah perkiraan mesin itu sendiri, dirata-ratakan untuk semua gambar. Angka ini bukan hasil perbandingan dengan teks aslinya, jadi baca lagi angka, nama, dan nominal sebelum Anda mengandalkannya.
File TXT disimpan sebagai UTF-8 dengan byte-order mark (BOM), yang membantu Notepad di Windows menampilkan huruf non-Latin dengan benar. Di file Word setiap baris menjadi paragraf sendiri. Dengan pengaturan kanan-ke-kiri (Arab, Ibrani, Persia, atau Urdu), paragraf-paragraf itu diatur dari kanan ke kiri dan rata kanan, dan dalam dokumen campuran arahnya ditentukan baris per baris, jadi baris berbahasa Inggris tetap rata kiri.
File berukuran 0 byte biasanya berarti foto yang tersimpan di penyimpanan cloud dan belum terunduh ke HP: buka dulu di galeri, lalu pilih lagi. Gambar yang dibuka langsung dari aplikasi chat kadang tidak bisa dibaca; simpan dulu ke HP, atau ambil tangkapan layarnya.
Foto yang miring terbaca lebih buruk daripada yang lurus. Luruskan dengan /rotate-image dan buang semua selain bagian teksnya dengan /crop-image. Untuk PDF hasil scan, pakai /pdf-ocr, yang mengubah setiap halaman menjadi gambar lalu membacanya satu per satu.
Halaman ini dalam bahasa lain: English · العربية · Deutsch · Français · Español · Русский · Português · 中文 · हिन्दी · Türkçe · עברית · فارسی · اردو · বাংলা