Fonctionne sur votre appareil · Votre fichier ne quitte jamais votre appareil.
Un courrier photographié, une capture d’écran, une facture scannée : la reconnaissance de texte lit les caractères sur l’image et vous rend du texte à copier – ou directement un fichier Word ou TXT.
Le français est reconnu avec ses accents et sa cédille ; l’anglais et l’arabe aussi. Le modèle tourne dans votre navigateur – l’image n’est pas envoyée, donc ni facture, ni pièce d’identité, ni courrier médical.
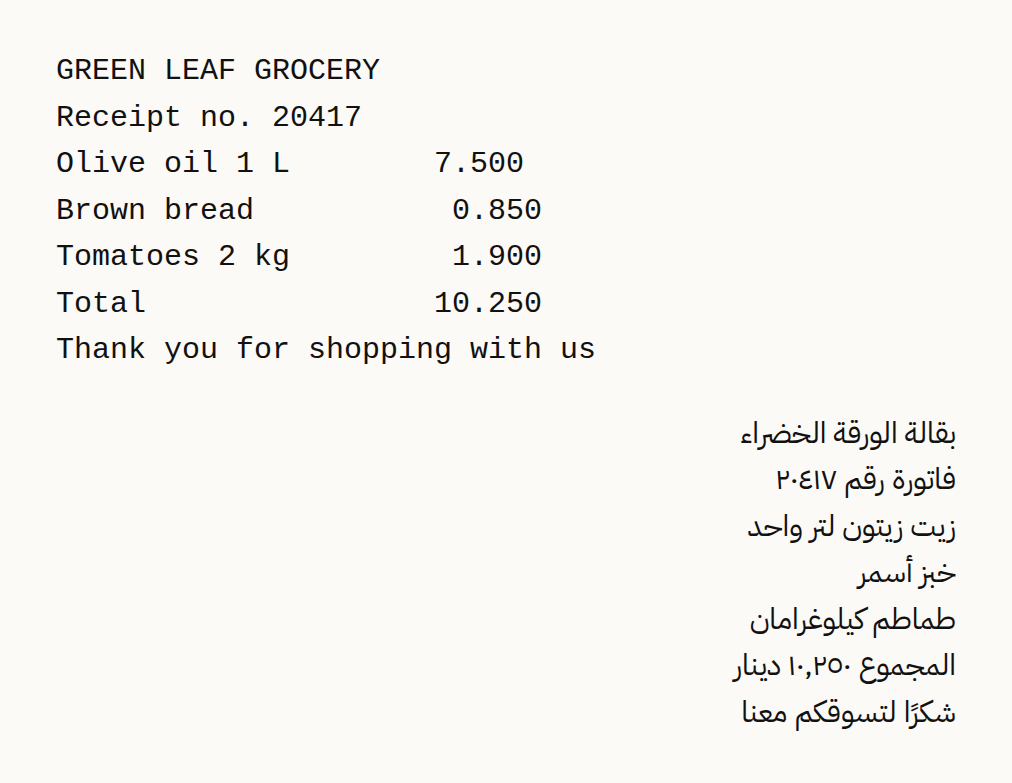
Nous avons passé une image de ticket de caisse en anglais et en arabe (fictif) (62.1 KB) dans cette page, depuis un navigateur, comme le ferait un visiteur, puis vérifié ce qui en est sorti. Les chiffres ci-dessous ont été mesurés sur le résultat, pas estimés.
Ce que cet exemple ne montre pas : Il s’agit d’une image nette et droite d’un texte imprimé. Les photos prises de biais, l’écriture manuscrite et les impressions pâles sont moins bien lues. Vérifiez les noms et les chiffres de vos propres yeux avant de vous y fier.
Mesuré le 2026-09-25 avec le code du site lui-même (build 8672737). Fichiers : grocery-receipt-ar-en.png résultat
Ne convient pas pour : L’écriture manuscrite et les polices très stylisées – sur du texte imprimé net, la reconnaissance est fiable ; sinon moins.
La liste propose 17 réglages : anglais, arabe, arabe et anglais ensemble, allemand, français, espagnol, russe, portugais, chinois simplifié et traditionnel, hindi, turc, hébreu, persan, ourdou, indonésien et bengali. Chacun charge le modèle de reconnaissance de cette langue : choisissez donc la langue dans laquelle le texte est écrit, pas celle de cette page. Un texte lu avec le mauvais modèle ressort en caractères faux ou dénués de sens.
Le réglage change aussi la mise en forme du texte. Pour les langues qui s’écrivent de gauche à droite, les suites d’espaces sont conservées, si bien que les colonnes d’un ticket de caisse ou d’un tableau simple restent séparées. Pour les langues qui s’écrivent de droite à gauche, c’est désactivé, car lors des tests cela collait les mots voisins. Quand l’arabe est sélectionné, les nombres écrits en chiffres arabes orientaux (dits indiens) sont lus une seconde fois, car le moteur les lit souvent mal au premier passage.
Un fichier vide, ou que le navigateur ne sait pas ouvrir, s’arrête avec un message qui le dit. Une photo HEIC d’iPhone est convertie en JPG sur votre appareil. Le moteur lit mal les petits caractères : une image de moins de 1 600 pixels de large est donc agrandie à environ 1 800 pixels avant la lecture, au plus quatre fois sa taille et sans dépasser 4 000 pixels sur le plus grand côté.
Plusieurs images peuvent être lues d’un coup. Dans le texte, chacune commence par une ligne qui indique son nom de fichier, et dans le fichier Word chacune se trouve sous son propre titre.
Le pourcentage de confiance est l’estimation du moteur lui-même, en moyenne sur toutes les images. Ce n’est pas une comparaison avec le vrai texte : relisez les nombres, les noms et les montants avant de vous y fier.
Le fichier TXT est enregistré en UTF-8 avec une marque d’ordre des octets (BOM), ce qui aide le Bloc-notes de Windows à afficher correctement les lettres non latines. Dans le fichier Word, chaque ligne devient un paragraphe. Avec un réglage de droite à gauche (arabe, hébreu, persan ou ourdou), ces paragraphes sont orientés de droite à gauche et alignés à droite ; dans un document mixte, le sens est décidé ligne par ligne, et les lignes en anglais restent alignées à gauche.
Un fichier de 0 octet est en général une photo restée dans le stockage en ligne et pas encore téléchargée sur le téléphone : ouvrez-la dans votre galerie, puis choisissez-la à nouveau. Une image ouverte directement depuis une messagerie ne peut parfois pas être lue ; enregistrez-la d’abord sur le téléphone, ou faites-en une capture d’écran.
Une photo de travers se lit moins bien qu’une photo droite. Redressez-la avec /rotate-image et coupez tout ce qui n’est pas du texte avec /crop-image. Pour un PDF scanné, utilisez /pdf-ocr, qui transforme chaque page en image et la lit.
Cette page dans d’autres langues: English · العربية · Deutsch · Español · Русский · Português · 中文 · हिन्दी · Türkçe · עברית · فارسی · اردو · Bahasa Indonesia · বাংলা