Converter PDF em Word
Funciona no seu dispositivo · Seu arquivo nunca sai do seu dispositivo.
Seu PDF vira um arquivo Word que você edita no Word, no LibreOffice ou no Google Docs. Tudo acontece no seu navegador: nada é enviado, não tem fila de espera nem limite de dois arquivos por hora.
Parágrafos, títulos, acentos, cedilhas e tabelas simples são mantidos na ordem de leitura. Contratos, currículos, notas fiscais e formulários com camada de texto de verdade dão o melhor resultado.
Exemplo prático: um teste medido desta ferramenta
Passamos um relatório em PDF de texto, em inglês e árabe, com uma tabela (fictício) (51.5 KB) por esta página em um navegador, do jeito que um visitante faria, e conferimos o que saiu. Os números abaixo foram medidos no resultado, não estimados.
- Configurações
- Os padrões da página: PDF para DOCX, um arquivo.
- Palavras em inglês presentes nas linhas em inglês (em qualquer ordem)
- 100 % (65 / 65)
- Texto em inglês como foi escrito, na ordem de leitura
- 100 %
- Números, totais e datas na própria linha, inglês
- 4 / 4
- Palavras em árabe presentes nas linhas em árabe (em qualquer ordem)
- 100 % (50 / 50)
- Texto em árabe como foi escrito, na ordem de leitura
- 99.3 %
- Números, totais e datas na própria linha, árabe
- 3 / 3
- Tabela reconstruída como tabela do Word (com as células preservadas)
- ✓ 16 / 16
- Parágrafos em árabe da direita para a esquerda
- 3 / 3
- Tempo no navegador de teste, do botão ao resultado
- 0.6 s
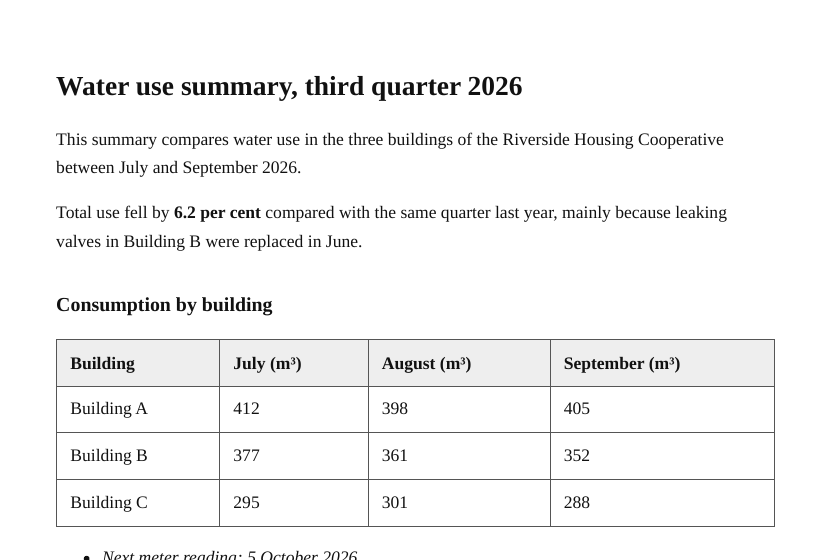
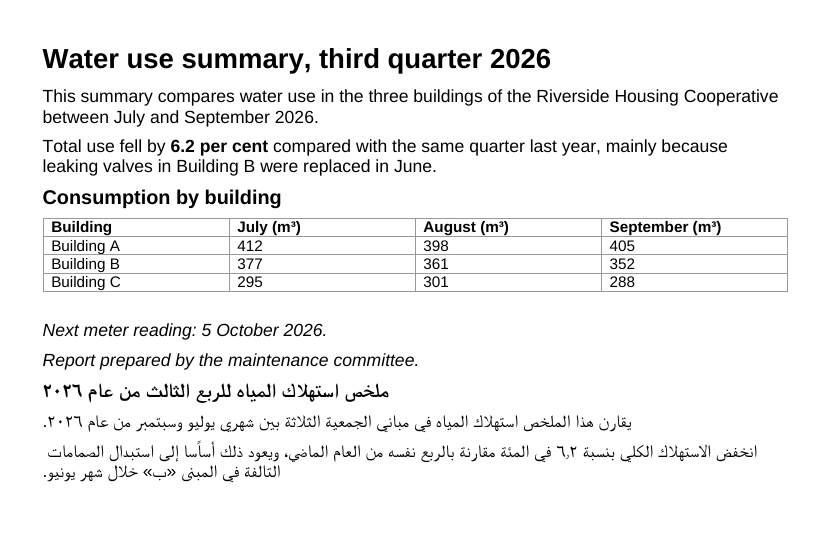
O que este exemplo não mostra: Este relatório é um PDF de texto com um título, uma tabela, uma lista e dois idiomas. Um PDF digitalizado não tem camada de texto e precisa passar antes por “Extrair texto de PDF” (OCR). Páginas diagramadas em várias colunas ou com caixas flutuantes saem como parágrafos na ordem de leitura, não como uma cópia exata da página.
Medido em 2026-09-25 com o próprio código do site (build 8672737). Arquivos: water-report-en-ar.pdf resultado
Como Converter PDF em Word
- Solte um PDF com texto de verdade (não um escaneado).
- Clique em «Converter tudo»: o texto é extraído página a página no seu navegador.
- Baixe o .docx e abra no Word, no LibreOffice ou no Google Docs.
Formatos suportados e limites
- Entrada
- PDF com camada de texto
- Saída
- Documento Word editável (.docx)
- Idiomas
- Português com acentos, ç e til, inglês, árabe, documentos mistos
- Onde roda
- No seu navegador — sem enviar nada
Não serve para: PDFs escaneados (use o reconhecimento de texto) e diagramação em várias colunas, tipo revista, que sai em blocos na ordem de leitura, não em cópia exata.
O que passa para o Word e o que fica para trás
Cada página do PDF vira uma página do documento, separada por uma quebra de página. O texto mantém o tamanho em pontos, e o negrito e o itálico são lidos das fontes que o PDF usa. Uma ou duas linhas claramente maiores que o texto normal viram um título de verdade no Word (Título 1, 2 ou 3, conforme o quanto são maiores), então o painel de navegação e o sumário automático funcionam.
Algumas coisas não passam. Todo o texto fica em Arial, qualquer que seja a fonte do PDF, e a cor do texto não é mantida. Links, comentários e campos de formulário não são lidos. Gráficos e logotipos desenhados com linhas e formas, e não guardados como imagens, não aparecem, embora as palavras dentro deles cheguem como texto. Números de página e cabeçalhos que se repetem chegam como linhas comuns, prontos para apagar.
Como as tabelas e as imagens são reconstruídas
As tabelas são encontradas pelo alinhamento das palavras, não por bordas desenhadas. Quando linhas seguidas se dividem em grupos de palavras nas mesmas posições horizontais, elas viram uma tabela do Word, com a primeira linha em negrito e marcada como linha de cabeçalho. Uma célula cujo texto quebra para uma segunda linha pode encerrar a tabela antes da hora, então confira as tabelas mais longas no olho.
As imagens guardadas no PDF voltam para a ordem de leitura no tamanho original e só são reduzidas quando passam de seis polegadas e meia de largura. Elas são salvas como PNG, que mantém a nitidez mas pode deixar o arquivo Word maior que o PDF quando há fotos.
PDFs protegidos e arquivos que voltam sem texto
Muitos PDFs com senha só restringem a edição ou a impressão; esses são convertidos sem pedir nada. Se um arquivo precisa de senha para abrir, aparece uma caixa pedindo a senha, e ela fica guardada para aquele arquivo enquanto a aba estiver aberta, então uma nova tentativa não pede de novo.
Se o resultado não tem texto editável — sai em branco ou só com imagens das páginas —, o PDF é um escaneado. O reconhecimento de texto (OCR) para PDF (/pdf-ocr) lê as letras dessas imagens e oferece o download em Word.
Quando o Word não é o melhor destino
Para um extrato bancário ou uma nota fiscal em que você quer trabalhar com os números, PDF para Excel (/pdf-to-excel) usa a mesma detecção de tabelas, coloca cada tabela numa planilha própria e guarda valores como 1,250.00 ou 1.250,00 como números que dá para somar. Se você só precisa das palavras, PDF para texto (/pdf-to-text) entrega a mesma ordem de leitura em texto simples. Você também pode soltar vários PDFs, ou um zip com eles, e cada um volta como um arquivo .docx separado.
Perguntas frequentes
- Dá para converter um PDF escaneado em Word?
- Um escaneado contém só a imagem da página, não o texto. Passe primeiro pelo reconhecimento de texto (OCR) para PDF: ele lê as letras — acentos, cedilha e til incluídos — e você recebe um documento Word.
- Meus arquivos são enviados para algum servidor?
- Não. A conversão acontece inteiramente no seu navegador, com a capacidade do seu próprio aparelho. O arquivo não sai do seu computador nem do seu celular, e, depois que você usa a ferramenta uma vez, ela continua funcionando sem internet (as de vídeo, de reconhecimento de texto e de remoção de fundo baixam o motor deste site no primeiro uso).
- O Word vai ficar igual ao PDF?
- Texto, parágrafos, títulos e tabelas simples são mantidos. Diagramações complexas em várias colunas ou com caixas soltas saem como texto corrido na ordem de leitura — editável, mas não uma cópia exata.
- Por que meu documento convertido veio vazio?
- O PDF não tinha camada de texto: era um escaneado ou uma foto. Abra-o no reconhecimento de texto (OCR), que lê as letras e devolve um documento Word.
- Precisa de conta ou assinatura?
- Não. Sem cadastro, sem e-mail, sem marca-d’água. O site é mantido por anúncios; a ferramenta em si é grátis, sem limite.
Ferramentas relacionadas
Esta página em outros idiomas: English · العربية · Deutsch · Français · Español · Русский · 中文 · हिन्दी · Türkçe · עברית · فارسی · اردو · Bahasa Indonesia · বাংলা