Перевести PDF в Word
Работает на вашем устройстве · Ваш файл никогда не покидает устройство.
Ваш PDF становится файлом Word, который можно редактировать в Word, LibreOffice или Google Документах. Всё происходит в браузере: ничего не загружается на сервер, нет очереди и лимита «два файла в час».
Абзацы, заголовки, кириллица и простые таблицы переносятся в порядке чтения. Лучше всего работают договоры, резюме, счета и анкеты с настоящим текстовым слоем.
Пример с замерами: как этот инструмент отработал на реальном файле
Файл для примера — текстовый PDF-отчёт на английском и арабском с таблицей (вымышленный) (51.5 KB). Мы обработали его на этой странице в браузере, как это сделал бы посетитель, и проверили, что получилось. Цифры ниже измерены на результате, а не прикинуты.
- Настройки
- Настройки страницы по умолчанию: PDF в DOCX, один файл.
- Английские слова в английских строках (в любом порядке)
- 100 % (65 / 65)
- Английский текст как написан, в порядке чтения
- 100 %
- Числа, суммы и даты в своей строке, английский
- 4 / 4
- Арабские слова в арабских строках (в любом порядке)
- 100 % (50 / 50)
- Арабский текст как написан, в порядке чтения
- 99.3 %
- Числа, суммы и даты в своей строке, арабский
- 3 / 3
- Таблица воссоздана как таблица Word (ячейки перенесены)
- ✓ 16 / 16
- Арабские абзацы с направлением справа налево
- 3 / 3
- Время в тестовом браузере от нажатия кнопки до результата
- 0.6 s
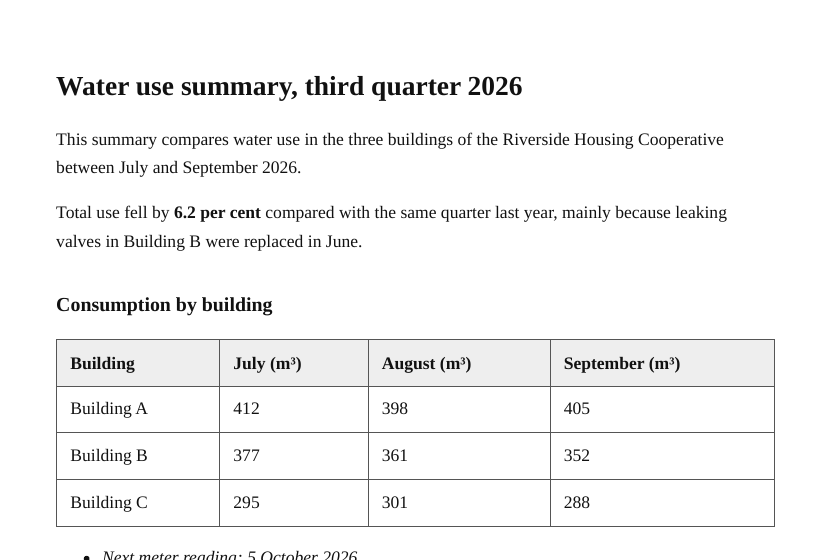
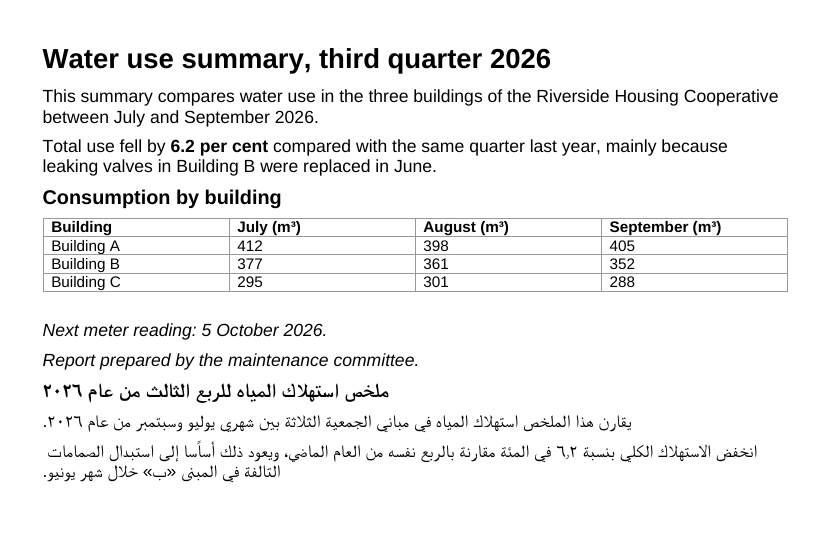
Чего этот пример не показывает: Этот отчёт — текстовый PDF с заголовком, таблицей, списком и двумя языками. У отсканированного PDF нет текстового слоя, поэтому его сначала нужно пропустить через «Извлечь текст из PDF» (OCR). Страницы, свёрстанные в несколько колонок или с плавающими блоками, переносятся абзацами в порядке чтения, а не точной копией страницы.
Измерено 2026-09-25 собственным кодом сайта (сборка 8672737). Файлы: water-report-en-ar.pdf результат
Как Перевести PDF в Word
- Перетащите PDF с настоящим текстом (не скан).
- Нажмите «Преобразовать все» — текст извлекается постранично в вашем браузере.
- Скачайте .docx и откройте его в Word, LibreOffice или Google Документах.
Поддерживаемые форматы и ограничения
- Вход
- PDF с текстовым слоем
- Выход
- Редактируемый документ Word (.docx)
- Языки
- Русский и другая кириллица, английский, арабский, смешанные документы
- Где работает
- В браузере — без загрузки на сервер
Не подходит для: Отсканированных PDF (для них есть распознавание текста) и журнальной вёрстки в несколько колонок — она превращается в блоки в порядке чтения, а не в точную копию.
Что переходит в файл Word, а что нет
Каждая страница PDF становится отдельной страницей документа, между ними стоит разрыв страницы. Текст сохраняет кегль, а полужирное и курсивное начертание определяется по шрифтам, которые использует PDF. Строка-другая, набранная заметно крупнее основного текста, становится настоящим заголовком Word (Заголовок 1, 2 или 3 — в зависимости от того, насколько она крупнее), поэтому работают и область навигации, и автоматическое оглавление.
Кое-что не переносится. Весь текст набирается шрифтом Arial, каким бы ни был шрифт в PDF, а цвет текста не сохраняется. Ссылки, комментарии и поля форм не считываются. Диаграммы и логотипы, нарисованные линиями и фигурами, а не вставленные картинками, пропадают, хотя слова внутри них приходят как текст. Номера страниц и колонтитулы оказываются обычными строками — их остаётся только удалить.
Как воссоздаются таблицы и картинки
Таблицы распознаются по тому, как выровнены слова, а не по нарисованным линиям. Если несколько строк подряд делятся на группы слов в одних и тех же местах по горизонтали, они становятся таблицей Word: первая строка выделяется полужирным и помечается как строка заголовка. Ячейка, текст которой переносится на вторую строку, может оборвать таблицу раньше времени, так что длинные таблицы проверьте глазами.
Картинки, хранящиеся в PDF, встают на свои места в порядке чтения в исходном размере; уменьшаются только те, что шире 6,5 дюйма. Сохраняются они в PNG: так они остаются чёткими, но если в документе есть фотографии, файл Word может получиться больше исходного PDF.
Защищённые PDF и файлы, в которых не оказалось текста
Многие PDF с паролем лишь запрещают редактирование или печать — такие преобразуются без лишних вопросов. Если же пароль нужен, чтобы открыть файл, появится окно для его ввода. Пароль запоминается для этого файла, пока вкладка открыта, так что при повторной попытке его не спросят снова.
Если в результате нет редактируемого текста — документ пуст или в нём только изображения страниц, — значит, перед вами скан; для него есть распознавание текста в PDF (/pdf-ocr).
Когда Word — не лучший вариант
Если в банковской выписке или счёте нужно работать с цифрами, PDF в Excel (/pdf-to-excel) использует то же распознавание таблиц, кладёт каждую таблицу на отдельный лист и сохраняет суммы вроде 1,250.00 или 1.250,00 как числа, которые можно складывать. Если нужны только слова, PDF в текст (/pdf-to-text) отдаёт тот же порядок чтения простым текстом. Можно перетащить и сразу несколько PDF или ZIP-архив с ними — каждый вернётся отдельным файлом .docx.
Частые вопросы
- Можно ли перевести отсканированный PDF в Word?
- Скан содержит только картинку страницы, а не текст. Сначала пропустите его через распознавание текста (OCR) для PDF: оно прочитает буквы — кириллицу тоже — и вы получите документ Word.
- Мои файлы загружаются на сервер?
- Нет. Преобразование целиком выполняется в вашем браузере, силами вашего же устройства. Файл не покидает компьютер или телефон, а инструмент, которым вы уже один раз воспользовались, работает и без интернета.
- Документ Word будет выглядеть точно как PDF?
- Текст, абзацы, заголовки и простые таблицы сохраняются. Сложная вёрстка в несколько колонок или с плавающими блоками превращается в сплошной текст в порядке чтения — редактируемый, но не точная копия.
- Почему документ после преобразования пустой?
- У PDF не было текстового слоя — это был скан или фото. Откройте его в распознавании текста (OCR): оно прочитает буквы и вернёт документ Word.
- Нужен аккаунт или подписка?
- Нет. Ни регистрации, ни электронной почты, ни водяных знаков. Сайт живёт за счёт рекламы; сам инструмент бесплатен без ограничений.
Похожие инструменты
Эта страница на других языках: English · العربية · Deutsch · Français · Español · Português · 中文 · हिन्दी · Türkçe · עברית · فارسی · اردو · Bahasa Indonesia · বাংলা