המרת PDF לוורד
פועל על המכשיר שלכם · הקובץ לא עוזב את המכשיר.
ה-PDF שלכם הופך לקובץ וורד שאפשר לערוך בוורד, ב-LibreOffice או ב-Google Docs. ההמרה מתבצעת בדפדפן: שום דבר לא מועלה, אין תור, ואין מגבלה של „שני קבצים בשעה“.
פסקאות, כותרות, עברית מימין לשמאל וטבלאות פשוטות עוברים לפי סדר הקריאה. חוזים, קורות חיים, חשבוניות וטפסים עם שכבת טקסט אמיתית נותנים את התוצאה הטובה ביותר.
דוגמה מעשית: הרצנו את הכלי ומדדנו את התוצאה
העברנו דוח PDF טקסטואלי באנגלית ובערבית, עם טבלה (בדוי) (51.5 KB) דרך העמוד הזה בדפדפן, כמו שמבקר היה עושה, ובדקנו מה יצא. הנתונים שלמטה נמדדו על התוצאה עצמה, הם לא הערכה.
- הגדרות
- ברירות המחדל של העמוד: מ-PDF ל-DOCX, קובץ אחד.
- מילים באנגלית שנמצאו בשורות האנגליות (בכל סדר)
- 100 % (65 / 65)
- הטקסט האנגלי כפי שנכתב, בסדר הקריאה
- 100 %
- מספרים, סכומים ותאריכים בשורה שלהם, אנגלית
- 4 / 4
- מילים בערבית שנמצאו בשורות הערביות (בכל סדר)
- 100 % (50 / 50)
- הטקסט הערבי כפי שנכתב, בסדר הקריאה
- 99.3 %
- מספרים, סכומים ותאריכים בשורה שלהם, ערבית
- 3 / 3
- הטבלה נבנתה מחדש כטבלת Word (התאים הועברו)
- ✓ 16 / 16
- פסקאות בערבית מוגדרות מימין לשמאל
- 3 / 3
- הזמן בדפדפן הבדיקה, מהלחיצה על הכפתור ועד התוצאה
- 0.6 s
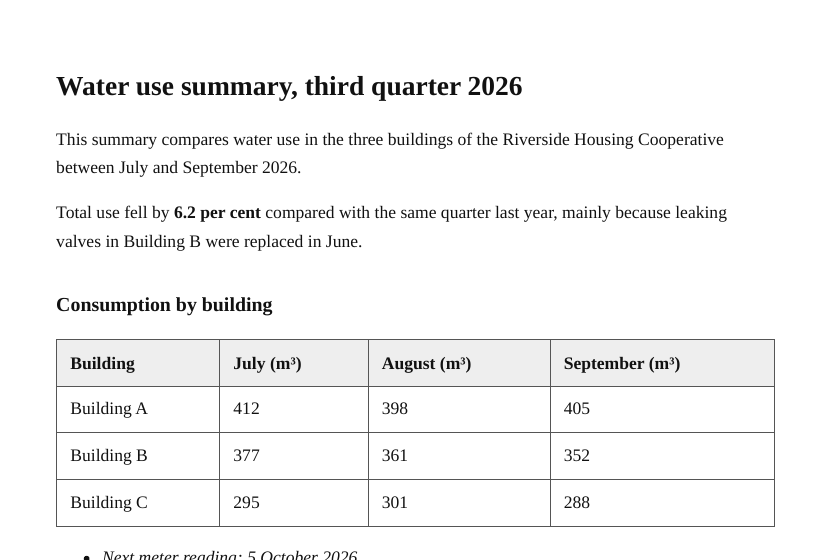
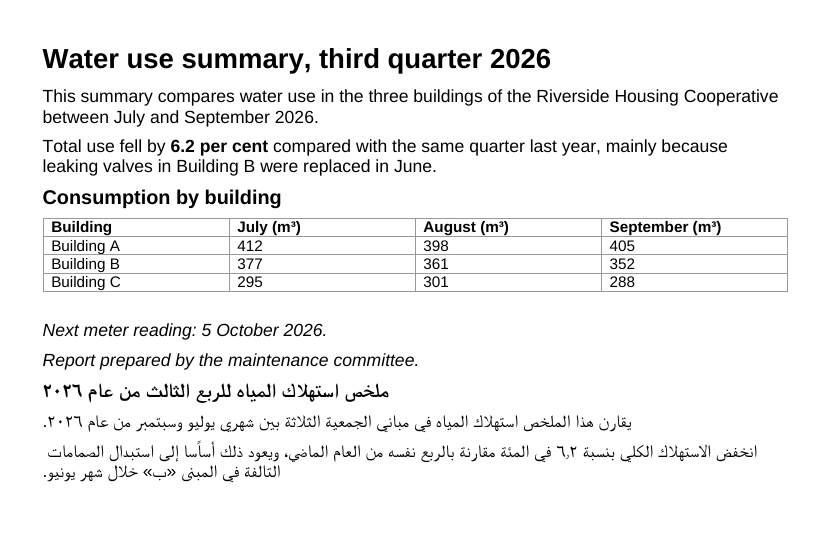
מה הדוגמה הזו לא מראה: הדוח הזה הוא PDF טקסטואלי עם כותרת, טבלה, רשימה ושתי שפות. ל-PDF סרוק אין שכבת טקסט, והוא צריך לעבור קודם דרך „חילוץ טקסט מ-PDF”. עמודים שמעוצבים בכמה טורים או עם תיבות צפות מגיעים כפסקאות בסדר הקריאה, לא כהעתק מדויק של העמוד.
נמדד ב-2026-09-25 בקוד של האתר עצמו (גרסה 8672737). קבצים: water-report-en-ar.pdf תוצאה
איך המרת PDF לוורד
- גררו PDF עם טקסט אמיתי (לא סריקה).
- לחצו «המרה» – הטקסט נקרא עמוד אחרי עמוד בדפדפן שלכם.
- הורידו את ה-.docx ופתחו בוורד, ב-LibreOffice או ב-Google Docs.
פורמטים נתמכים ומגבלות
- קלט
- PDF עם שכבת טקסט
- פלט
- קובץ וורד לעריכה (.docx)
- שפות
- עברית מימין לשמאל, אנגלית, ערבית, מעורב
- איפה זה רץ
- בדפדפן – בלי העלאה
לא מיועד ל: קובצי PDF סרוקים (בשבילם יש זיהוי טקסט) ועיצובים רב-טוריים כמו מגזינים – הם הופכים לגושי טקסט לפי סדר קריאה, לא לעותק מדויק.
מה עובר לקובץ הוורד ומה לא
כל עמוד ב-PDF הופך לעמוד משלו במסמך, עם מעבר עמוד ביניהם. הטקסט שומר על גודל הגופן, והדגשה ונטוי נקראים מהגופנים שה-PDF משתמש בהם. שורה או שתיים שגדולות בבירור מטקסט הגוף הופכות לכותרת אמיתית בוורד (כותרת 1, 2 או 3, לפי הפער בגודל), ולכן חלונית הניווט ותוכן עניינים אוטומטי עובדים.
יש דברים שלא עוברים. כל הטקסט מוגדר בגופן Arial, לא משנה באיזה גופן השתמש ה-PDF, וצבע הטקסט לא נשמר. קישורים, הערות ושדות טופס לא נקראים. תרשימים ולוגואים שמצוירים מקווים וצורות, ולא שמורים כתמונות, לא מופיעים, אם כי המילים שבתוכם עוברות כטקסט. מספרי עמודים וכותרות רצות מגיעים כשורות רגילות, מוכנים למחיקה.
איך טבלאות ותמונות נבנות מחדש
טבלאות מזוהות לפי האופן שבו המילים מסתדרות, לא לפי קווי גבול מצוירים. כששורות רצופות מתפצלות כל אחת לקבוצות מילים באותם מיקומים אופקיים, הן הופכות לטבלת וורד, שהשורה הראשונה שלה מודגשת ומסומנת כשורת כותרת. תא שהטקסט שלו גולש לשורה שנייה עלול לסיים את הטבלה מוקדם מדי, אז בדקו טבלאות ארוכות בעין.
תמונות ששמורות ב-PDF חוזרות למקומן בסדר הקריאה בגודלן המקורי, ומוקטנות רק אם הן רחבות משש וחצי אינץ׳. הן נשמרות כ-PNG, ששומר עליהן חדות, אבל עלול להפוך את קובץ הוורד לגדול מה-PDF כשיש בו תצלומים.
PDF נעול וקבצים שחוזרים בלי טקסט
הרבה קובצי PDF מוגנים בסיסמה רק מגבילים עריכה או הדפסה; אלה מומרים בלי לבקש דבר. אם קובץ צריך סיסמה כדי להיפתח, תיבה מבקשת אותה, והסיסמה נזכרת לאותו קובץ בלבד כל עוד הכרטיסייה פתוחה, כך שניסיון חוזר לא שואל שוב.
אם התוצאה ריקה או מכילה רק תמונות של העמודים, ה-PDF הוא סריקה: זיהוי טקסט ל-PDF (/pdf-ocr) קורא את האותיות מהתמונות ומציע הורדה כוורד.
כשוורד הוא לא היעד המתאים
לדף חשבון בנק או לחשבונית שרוצים לעבוד עם המספרים שבהם, PDF לאקסל (/pdf-to-excel) משתמש באותו זיהוי טבלאות, שם כל טבלה בגיליון משלה, ושומר סכומים כמו 1,250.00 או 1.250,00 כמספרים שאפשר לסכם. אם צריך רק את המילים, PDF לטקסט (/pdf-to-text) נותן את אותו סדר קריאה כטקסט פשוט. אפשר גם לגרור כמה קובצי PDF, או zip שלהם, וכל אחד חוזר כקובץ .docx נפרד.
שאלות נפוצות
- אפשר להמיר PDF סרוק לוורד?
- סריקה מכילה רק תמונה של העמוד, לא טקסט. השתמשו קודם בזיהוי טקסט (OCR) ל-PDF: הוא קורא את הכתב מהתמונה – גם בעברית – ומחזיר לכם קובץ וורד.
- האם הקובץ שלי נשלח לשרת?
- לא. ההמרה מתבצעת כולה בדפדפן, בכוח המכשיר שלכם, והקובץ לא יוצא מהמחשב או מהטלפון. אחרי שהשתמשתם בכלי פעם אחת, הוא ממשיך לעבוד גם בלי אינטרנט (כלי הווידאו, זיהוי הטקסט והסרת הרקע מורידים את המנוע שלהם מהאתר הזה בפעם הראשונה).
- קובץ הוורד ייראה בדיוק כמו ה-PDF?
- טקסט, פסקאות, כותרות וטבלאות פשוטות עוברים. עיצובים מורכבים עם כמה טורים או תיבות טקסט חופשיות מגיעים כטקסט רציף לפי סדר הקריאה – ניתן לעריכה, אבל לא עותק מדויק.
- למה המסמך ריק אחרי ההמרה?
- ל-PDF לא הייתה שכבת טקסט – זו הייתה סריקה או תמונה. פתחו אותו עם זיהוי טקסט (OCR); הוא יזהה את הכתב וייתן לכם מסמך וורד.
- צריך חשבון או מנוי?
- לא. בלי הרשמה, בלי כתובת מייל, בלי סימן מים. האתר ממומן מפרסומות; הכלי עצמו חינמי בלי הגבלה.
כלים קשורים
עמוד זה בשפות אחרות: English · العربية · Deutsch · Français · Español · Русский · Português · 中文 · हिन्दी · Türkçe · فارسی · اردو · Bahasa Indonesia · বাংলা