PDF'yi Word'e çevirme
Cihazınızda çalışır · Dosyanız cihazınızdan asla çıkmaz.
PDF'niz, Word, LibreOffice ya da Google Dokümanlar'da düzenleyebileceğiniz bir Word dosyasına dönüşür. İşlem tarayıcınızda yapılır: hiçbir şey yüklenmez, sıra beklenmez, „saatte iki dosya“ sınırı yoktur.
Paragraflar, başlıklar, Türkçe karakterler (ş, ğ, ı, ö, ü, ç) ve basit tablolar okuma sırasıyla aktarılır. Sözleşmeler, dilekçeler, faturalar ve gerçek metin katmanı olan formlar en iyi sonucu verir.
Uygulamalı örnek: bu araçla yapılmış, ölçülmüş bir deneme
Bu sayfayı bir ziyaretçi gibi tarayıcıda kullandık: girdi olarak İngilizce ve Arapça, tablo içeren, metin tabanlı bir PDF rapor (kurgusal) (51.5 KB) verdik ve çıkan sonucu kontrol ettik. Aşağıdaki değerler tahmin değil, doğrudan sonuç üzerinde ölçüldü.
- Ayarlar
- Sayfanın varsayılanları: PDF’den DOCX’e, tek dosya.
- İngilizce satırlarda bulunan İngilizce kelimeler (sıra fark etmez)
- 100 % (65 / 65)
- İngilizce metin yazıldığı gibi, okuma sırasında
- 100 %
- Kendi satırındaki sayılar, toplamlar ve tarihler, İngilizce
- 4 / 4
- Arapça satırlarda bulunan Arapça kelimeler (sıra fark etmez)
- 100 % (50 / 50)
- Arapça metin yazıldığı gibi, okuma sırasında
- 99.3 %
- Kendi satırındaki sayılar, toplamlar ve tarihler, Arapça
- 3 / 3
- Tablo, Word tablosu olarak yeniden kuruldu (hücreler aktarıldı)
- ✓ 16 / 16
- Sağdan sola dizilen Arapça paragraflar
- 3 / 3
- Test tarayıcısında geçen süre, düğmeden sonuca
- 0.6 s
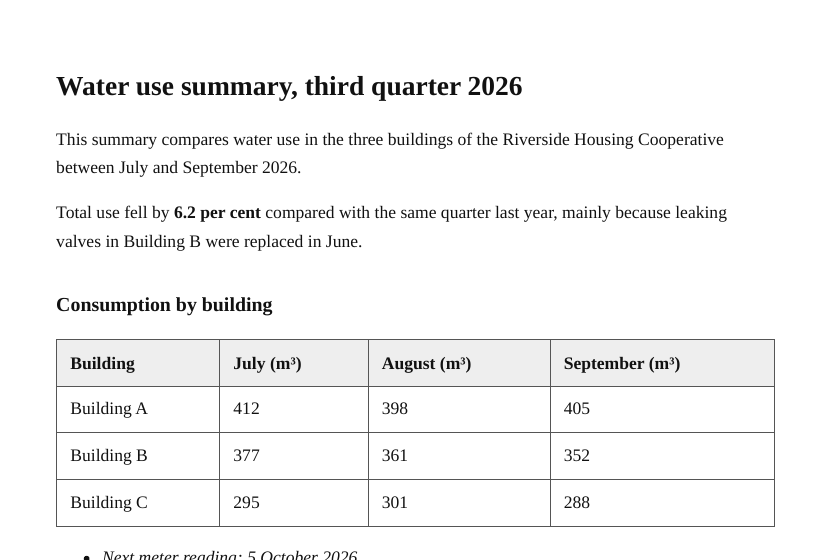
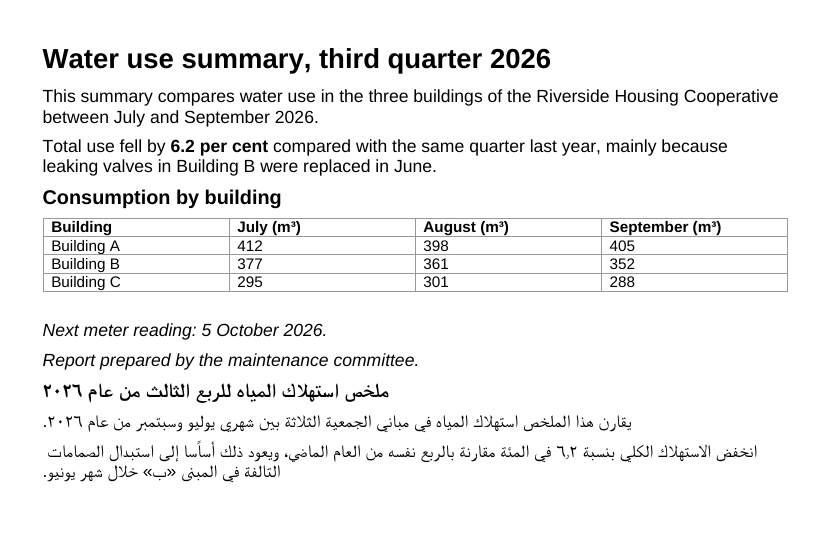
Bu örneğin göstermedikleri: Bu rapor başlık, tablo, liste ve iki dil içeren, metin tabanlı bir PDF. Taranmış bir PDF’in metin katmanı yoktur; önce PDF metin tanıma (OCR) gerekir. Birkaç sütuna dizilmiş ya da yüzen kutular içeren sayfalar, sayfanın birebir kopyası olarak değil, okuma sırasına göre paragraflar halinde gelir.
2026-09-25 tarihinde sitenin kendi koduyla ölçüldü (derleme 8672737). Dosyalar: water-report-en-ar.pdf sonuç
PDF'yi Word'e çevirme nasıl yapılır
- Gerçek metin içeren bir PDF bırakın (tarama değil).
- «Dönüştür» düğmesine basın; metin sayfa sayfa tarayıcınızda okunur.
- .docx dosyasını indirin ve Word, LibreOffice ya da Google Dokümanlar'da açın.
Desteklenen biçimler ve sınırlar
- Girdi
- Metin katmanı olan PDF
- Çıktı
- Düzenlenebilir Word dosyası (.docx)
- Diller
- Türkçe (ş, ğ, ı, ö, ü, ç ile), İngilizce, Arapça, karışık
- Nerede çalışır
- Tarayıcıda – yükleme yok
Şunlar için uygun değildir: Taranmış PDF’ler (onlar için metin tanıma var) ve dergi gibi çok sütunlu tasarımlar: bunlar okuma sırasında metin bloklarına dönüşür, birebir kopyaya değil.
Word dosyasına neler geçer, neler geçmez
PDF’nin her sayfası belgede ayrı bir sayfa olur; sayfaların arasına sayfa sonu konur. Metin punto büyüklüğünü korur; kalın ve italik, PDF’nin kullandığı yazı tiplerinden okunur. Gövde metninden belirgin biçimde büyük dizilmiş bir iki satır gerçek bir Word başlığına dönüşür (ne kadar büyük olduğuna göre Başlık 1, 2 ya da 3); böylece gezinti bölmesi de otomatik içindekiler tablosu da çalışır.
Bazı şeyler aktarılmaz. PDF hangi yazı tipini kullanmış olursa olsun bütün metin Arial ile dizilir ve metin rengi korunmaz. Bağlantılar, yorumlar ve form alanları okunmaz. Resim olarak saklanmayıp çizgi ve şekillerle çizilmiş grafikler ve logolar görünmez, ama içlerindeki sözcükler metin olarak gelir. Sayfa numaraları ve üst bilgiler sıradan satırlar olarak gelir; silmeniz yeterli.
Tablolar ve resimler nasıl yeniden kurulur
Tablolar çizili kenarlıklardan değil, sözcüklerin nasıl hizalandığından bulunur. Art arda gelen satırların her biri aynı yatay konumlarda sözcük gruplarına ayrılıyorsa bu satırlar bir Word tablosu olur; ilk satır kalın yazılır ve başlık satırı olarak işaretlenir. Metni ikinci satıra taşan bir hücre tabloyu erken bitirebilir; uzun tabloları gözle kontrol edin.
PDF’de saklanan resimler özgün boyutlarıyla okuma sırasındaki yerlerine döner; yalnızca altı buçuk inçten genişse küçültülür. PNG olarak kaydedilirler: bu onları keskin tutar, ama fotoğraf içeren bir belgede Word dosyası PDF’den büyük çıkabilir.
Parolalı PDF’ler ve metinsiz dönen dosyalar
Parola korumalı PDF’lerin çoğu yalnızca düzenlemeyi ya da yazdırmayı kısıtlar; bunlar hiçbir şey sorulmadan dönüşür. Dosyayı açmak için parola gerekiyorsa bir kutu onu ister. Parola, sekme açık kaldığı sürece o dosya için hatırlanır; yeniden denediğinizde tekrar sorulmaz.
Sonuçta düzenlenebilir metin yoksa, yani belge boşsa ya da yalnızca sayfa görüntüleri içeriyorsa, PDF bir taramadır; bunun için PDF metin tanıma (/pdf-ocr) aracı var.
Word en iyi seçenek olmadığında
Rakamlarla çalışmak istediğiniz bir banka hesap dökümü ya da fatura için PDF’den Excel’e (/pdf-to-excel) aynı tablo algılamayı kullanır, her tabloyu ayrı bir çalışma sayfasına koyar ve 1,250.00 ya da 1.250,00 gibi tutarları toplanabilir sayılar olarak saklar. Yalnızca sözcüklere ihtiyacınız varsa PDF’den metne (/pdf-to-text) aynı okuma sırasını düz metin olarak verir. Birden çok PDF’yi ya da bunların ZIP’ini de bırakabilirsiniz; her biri ayrı bir .docx dosyası olarak döner.
Sık sorulan sorular
- Taranmış (fotoğrafı çekilmiş) bir PDF'yi Word'e çevirebilir miyim?
- Tarama, sayfanın yalnızca görüntüsünü içerir, metnini değil. Bunun için önce PDF metin tanıma (OCR) aracını kullanın: yazıyı görüntüden okur – Türkçe karakterlerle – ve size bir Word dosyası verir.
- Dosyam bir sunucuya yükleniyor mu?
- Hayır. Dönüştürme tamamen tarayıcınızda, kendi cihazınızın gücüyle yapılır. Dosya bilgisayarınızdan ya da telefonunuzdan çıkmaz; bir araç bir kez kullanıldıktan sonra internetsiz de çalışmaya devam eder.
- Word dosyası PDF'nin aynısı mı görünür?
- Metin, paragraflar, başlıklar ve basit tablolar aktarılır. Çok sütunlu ya da serbest yerleştirilmiş metin kutuları olan tasarımlar, okuma sırasına göre düz metin olarak gelir: düzenlenebilir, ama birebir kopya değil.
- Dönüştürdükten sonra belge neden boş?
- PDF'nin metin katmanı yoktu; bir tarama ya da fotoğraftı. Dosyayı metin tanıma (OCR) ile açın; yazıyı tanır ve Word belgesi olarak verir.
- Üyelik ya da abonelik gerekiyor mu?
- Hayır. Kayıt yok, e-posta yok, filigran yok. Site reklamla ayakta durur; aracın kendisi sınırsız ve ücretsizdir.
İlgili araçlar
Bu sayfa diğer dillerde: English · العربية · Deutsch · Français · Español · Русский · Português · 中文 · हिन्दी · עברית · فارسی · اردو · Bahasa Indonesia · বাংলা